你的 AI 评审提了 18 条意见,你一条都没看
PR 提上去,评审机器人几分钟甩来一长串评论。
头两条还读,第三条开始扫,第五条开始烦,到第十条直接点"全部已解决"。下次它再说话,你连点都不点。
这不是你的问题,是那套东西的设计有问题:它在拼命多报,你只想让它闭嘴。
阿里把这套系统开源了,叫 Open Code Review。它做的第一个决定是反过来的——宁可漏,也不吵。
报三条,一条是真的
先看一组不太好看的数字。
用 Claude Code 直接做代码评审,精确率 **28.90%**。翻译一下:它报出来的评论,三条里大概一条是真问题。召回率 11.57%——真问题十个里找到一个。
剩下九条评论在消耗你的注意力,也在训练你"看见就划过去"。
换成 Open Code Review,同一个模型(Claude 4.6 Opus):
精确率 **33.90%**,召回率 20%。
还是不高。但报出来的三条里,有一条以上是真的。
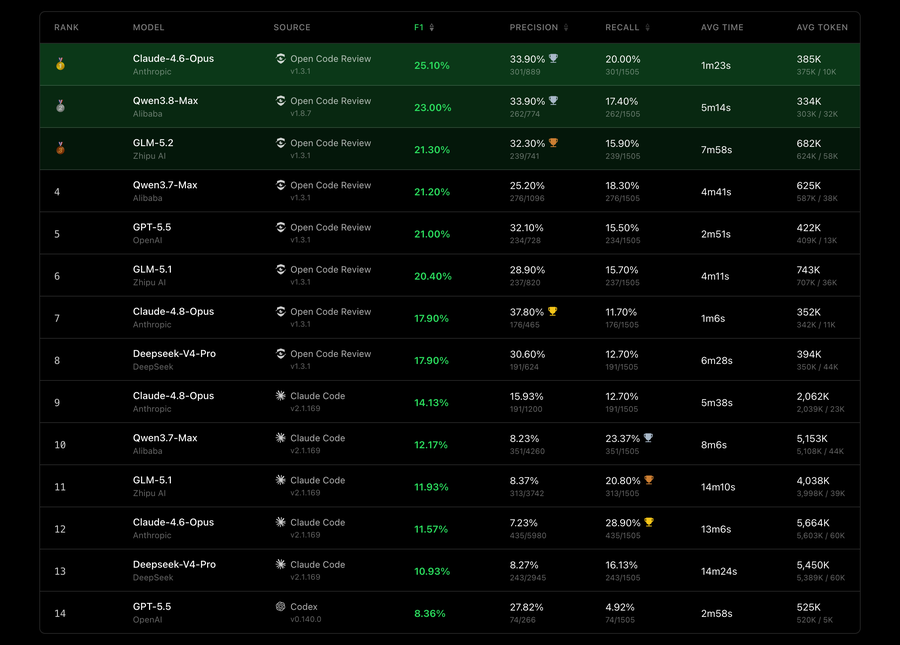
按 F1 算,**25.10% 对 11.57%**。
这个绝对值说明一件事:AI 代码评审这件事,现在还没有一家到能替人签字的程度。真正的差别不是谁更神,是谁离及格线近一点。
官方自己承认了另一半:
它的召回率低于通用 agent——这是刻意的取舍,用精度换少一点噪音。
也就是说,它会漏 bug。它赌的是另一件事:一个被无视的评审工具等于零。
他们把不该出错的部分,从模型手里拿走了
一个模型,怎么做到省 14 倍 token、快 9 倍、还准一点?
答案不在模型,在喂给模型的东西。
通用 agent 评审的流程大致是:把 diff 全丢进去,让它自己决定先看哪个文件、哪些可以跳过、用什么标准看。这三件事它每一件都可能判断错——改动一大的时候它就会"偷工减料",挑几个文件看完就说完了。
Open Code Review 把这三件事全部收回到代码里:
哪些文件必须审,工程逻辑判定。 不是模型扫一眼觉得差不多。
相关文件强制打成包。 它举的例子很具体:message_en.properties 和 message_zh.properties 必须一起看。否则你改了英文忘了中文,这种问题永远发现不了。每个包跑一个独立上下文的子 agent,天然并发,改动再大也不崩。
规则用模板引擎匹配到文件。 而不是让模型自己判断"这条规则适不适用"。自然语言引导不稳定,模板引擎稳定。
评论的定位和内容各有一个模块二次校验。 这条直接对着最常见的病:报出来的问题对不上代码位置,行号飘了,你打开一看不是那行,于是关掉——然后就再也不看了。
留下真正需要判断的——动态决策、动态取上下文——才交给模型。连工具集都是从生产数据的调用轨迹里蒸馏出来的。
顺便说一句,这不是算法上的新东西。它就是把"评审这件事该有清单、该有覆盖率"这条老规矩,用代码强制执行了。
省下的十四分之十三
机制说到这儿,两个数字就顺理成章了。
同一个模型,同一批 PR:
| Open Code Review | Claude Code | |
|---|---|---|
| 平均 token | 38.5 万 | 566 万 |
| 平均耗时 | 1 分 23 秒 | 13 分 6 秒 |
token 是 1/14.7。
省下来的不是模型变聪明了,是它不再把整个仓库翻一遍。通用 agent 为了"看全",会把大量无关文件塞进上下文,token 就这么烧掉。
对每天几十个 PR 的团队,这个差别不是省钱,是能不能塞进 CI 的问题——13 分钟的评审没人等,1 分半的可以挂上去。
两年,500 万次,才敢开源
这套东西不是为开源现做的。
它在阿里内部跑了两年,2 万多活跃用户,累计 500 万次真实评审任务,找出数百万个缺陷,验证完才孵成开源项目。npm 上过去 30 天 69 万次下载。
这个背景解释了那些设计为什么这么具体。message_en/zh.properties 这种例子,只有真的在几十万行的企业代码库里被坑过才想得出来——它不是从论文里读来的典型场景。
也解释了它为什么敢把 F1 25% 挂在 README 第一屏。在内部它本来就不是拿来炫指标的,是拿来用的:一个会被无视的工具,指标漂亮也没人开。
评测集本身也按真实场景搭:50 个开源仓库、200 个真实 PR、10 种语言,80 多位资深工程师交叉验证出 1,505 条标注好的真问题。不是合成数据。
没有 API Key 也能先跑
ocr CLI 加一套 Agent Skill,两种模式:
原生模式——用它自己的评审流水线,需要一个模型 endpoint。 委托模式——用你现有的 coding agent(Claude Code、Codex、Cursor、Kimi Code 都行)跑分析,它只提供流水线和护栏:选文件、解析规则、覆盖率要求、结构化报告。
没有单独的 Key,直接用委托模式,走你 agent 现有的认证和额度。
# 装 skill
npx skills add alibaba/open-code-review

# 或只装 CLI
npm install -g   @alibaba-group/open-code-review
前置条件只有一个:Git ≥ 2.41。它靠 Git 生成 diff、搜代码、做仓库操作。
原生模式配好模型后:
ocr config provider
ocr config model
ocr review
除了评审 diff,ocr scan 可以整文件扫——接手陌生代码库、或者某个目录根本没 diff 时用。
三十行的小 PR 别用它
一个改了三行的 PR,扫一眼就完了,为它装一套工具是多余的。
你要的是"帮我读一遍这段代码说说感觉"——开放式问答,通用 agent 比流水线合适。
它擅长的是另一类:改动涉及十几个文件、要在 CI 里跑、报告得贴进 PR 评论、还有人在等你意见。这种时候你要的是每次都给同样标准的结果。
最后一条得说清楚:25% 的 F1 意味着它现在的位置是"多一双眼睛",不是"替你签字"。它报的问题值得看,它没报的地方不代表干净。
相关链接:
暂无评论。