错位打了两年,这次腾讯和阿里躲不开了
10 月 29 日,阿姆斯特丹,云栖大会欧洲站。
千问的研究科学家在现场说了一句话:Qwen4,下周发布。
第二天,腾讯那边也放出消息,Hy4 正式版即将上线。
两家第一次把版本号对齐到同一个数字上。
这不是小事。过去两年,中国两家最强的大模型团队,一直在打一场"错位战"——你发 3,我发 2.5;你发 3.5,我等三个月再发 4。永远差半代,就永远不用被拉出来逐项对比。
这次躲不开了。
先看两年的错位史
| 时间 | 事件 |
|---|---|
| 2025-09 | 阿里 Qwen3-Max 正式版上线 |
| 2025-12-05 | 腾讯 Hy2 发布,晚了三个月 |
| 2026-02 | 腾讯重建预训练与强化学习基础设施 |
| 2026-07-06 | 腾讯 Hy3 正式版,295B / 21B 激活,256K |
| 2026-08-03 | 阿里 Qwen3.8-Max,版本号仍停在 3 |
| 2026-08-28 | 腾讯 Hy4 preview,770B / 49B 激活,1M |
看清楚这个节奏:2025 年是阿里先发、腾讯跟;2026 年反过来了,腾讯 7 月先出 Hy3 正式版,阿里 8 月只发了个 3.8,大版本号咬着 3 不放。
为什么都爱这么打?因为"差半代"是最好的公关。你 3.8 对我 4 preview,赢了是我越级,输了是我还没正式发。谁都不用承认自己落后。
现在两家同时跳到 4,这层缓冲没了。
腾讯这边,牌已经摊在桌上
Hy4 preview 是 8 月 28 日放出来的,不是 PPT,是能下载的权重。
硬参数:
- 总参数 770B,激活 49B(Hugging Face 文件页显示 780B,多出来的 10B 是内置 MTP 投机解码层,官方口径只算 backbone)
- 78 层,第 1 层 dense FFN,其余 77 层 MoE;每层 256 个路由专家 + 1 个共享专家,每 token 激活 top-8
- 隐藏维度 6144,4 条残差流
- 注意力用 Gated DSA + IndexCache,跨层复用稀疏索引
- 上下文 1M tokens,词表 120,832
- 协议 Apache 2.0,权重在 Hugging Face、ModelScope、GitCode、CNB 都能下
对比上一代 Hy3:295B / 21B、256K 上下文。半年时间,参数翻 2.6 倍,上下文翻 4 倍。
价格也一起涨了:
| 模型 | 输入(元/百万 tokens) | 输出 | 缓存命中 |
|---|---|---|---|
| Hy4 preview | 6 | 18 | 0.3 |
| Hy3 | 1 | 4 | 0.25 |
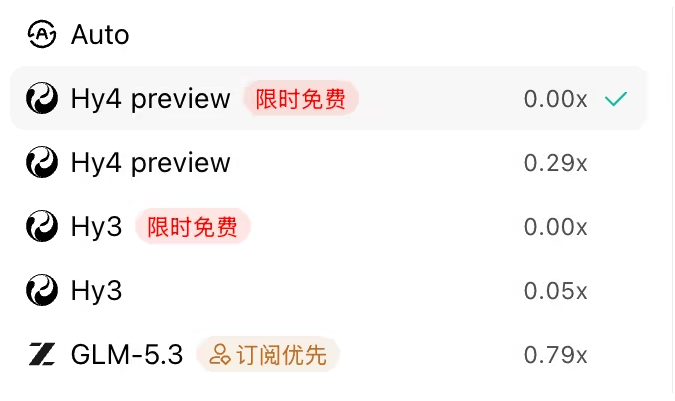
输入贵 6 倍,输出贵 4.5 倍。放到同代旗舰里算中等——比 Kimi K3 的 20 / 100 便宜一大截,也略低于 GLM-5.3 的 8 / 28。
但自部署门槛不低:vLLM 和 SGLang 都还没有现成支持,得从源码编译;BF16 权重约 1.5TB,FP8 约 770GB,至少 8 卡才跑得动。所谓"开源",对个人开发者来说更多是"能看、能改、能验证",不是"能在家跑"。
阿里这边,只露了半个牌面
Qwen4 目前已知的是四款型号:
- Qwen4-Max:旗舰闭源
- Qwen4-Plus / Qwen4-Flash:分层闭源,走性价比
- Qwen4-27B:开源档,先放这个
一个能查到的硬证据:10 月 28 日,千问的 qwen-code 仓库合并了 PR #15762,把所有以 qwen4 开头的模型 ID 默认上下文,从 262,144 提到 1,000,000。自动压缩阈值从 222,822 提到 850,000,硬阈值从 239,144 提到 977,000。
代码先改,发布会后开——这是典型的"已经准备好了,只等按下按钮"。
云栖现场还透露了两件事,比参数更有意思:
一是 RSI(自我进化)。从真实内测日志和用户反馈里自动找能力缺口,自动构造训练数据,先在小模型上多轮验证,再喂给 Max。一个多月跑了 33 轮数据迭代,30 天内把 Qwen3.8-Max 的 AA 智能指数从 40 拉到 45。
二是芯模协同。千问接进工业级 EDA,连续跑 60 多个小时、调用数万次工具,在保性能的前提下把芯片面积缩减 42%。
一个是"模型改自己",一个是"模型改芯片"。这两件事如果坐实,比多几千亿参数值钱得多。
所以下周到底看什么
第一,看开源档位的诚意。
腾讯这边是全系 Apache 2.0,770B 直接放权重,但 8 卡起步;阿里这边只放 27B,Max 继续闭源。
对普通开发者,27B 才是能单机跑的那个。如果 Qwen4-27B 真能在 262K 到 1M 上下文下保持可用,它会成为明年最实用的开源底座之一。腾讯的 770B 更像是给云厂商和大企业准备的"我能开源"的姿态。
第二,看 1M 上下文是不是真能用。
两家都喊 1M。但上下文长度和"有效上下文"是两回事——大部分模型在 20 万 token 之后就开始丢中间信息。
更现实的问题是价格:1M token 输入,按 Hy4 的 6 元/百万算,一次调用 6 块钱;同样的活干十次,60 块。上下文越长,账单越像话费单。
所以真正该问的不是"支持多长",是"多长之后还能记住重点,且我付得起"。
第三,看价格怎么定。
Hy4 preview 已经把锚抛下来了:6 / 18,缓存 0.3。Qwen4-Max 如果定得比这个高,就得在能力上给出足够明显的差距;定得低,就是直接掀桌子。
过去两年,中国大模型的价格战基本是"半年降一个数量级"。这次两家同代正面撞,降价可能会来得更快。
我的判断
这场对决,比的不是谁更聪明。
参数、上下文、榜单,两家大概率会打成互有胜负——你赢代码,我赢数学,他赢长文本,谁也不服谁。
真正决定胜负的是三件很土的事:能不能被用得起、能不能被部署得了、能不能被信任。
腾讯选的路是"开源换生态":权重全放,但门槛高,实际受益的是有卡的人。阿里选的路是"分层换覆盖":小模型开源抢开发者,大模型闭源收钱。
两条路都成立,但用户会用手投票。
对我们这些写代码、做产品的人来说,下周最值得做的事不是看发布会,是等权重和价格页更新,然后拿自己手上最脏的那个任务去跑一遍。
榜单会骗人,账单不会。
相关链接:
- 腾讯混元官网:https://hunyuan.tencent.com
- Hy4 preview 权重(Hugging Face):https://huggingface.co/tencent/Hy4-preview
- Hy4 preview 权重(ModelScope):https://modelscope.cn/models/Tencent-Hunyuan/Hy4-preview
- 千问官网:https://qwen.ai
- 千问开源仓库:https://github.com/QwenLM
- qwen-code(1M 上下文改动所在仓库):https://github.com/QwenLM/qwen-code
暂无评论。