谷歌的世界模型会配音了:改个天气,环境音跟着变
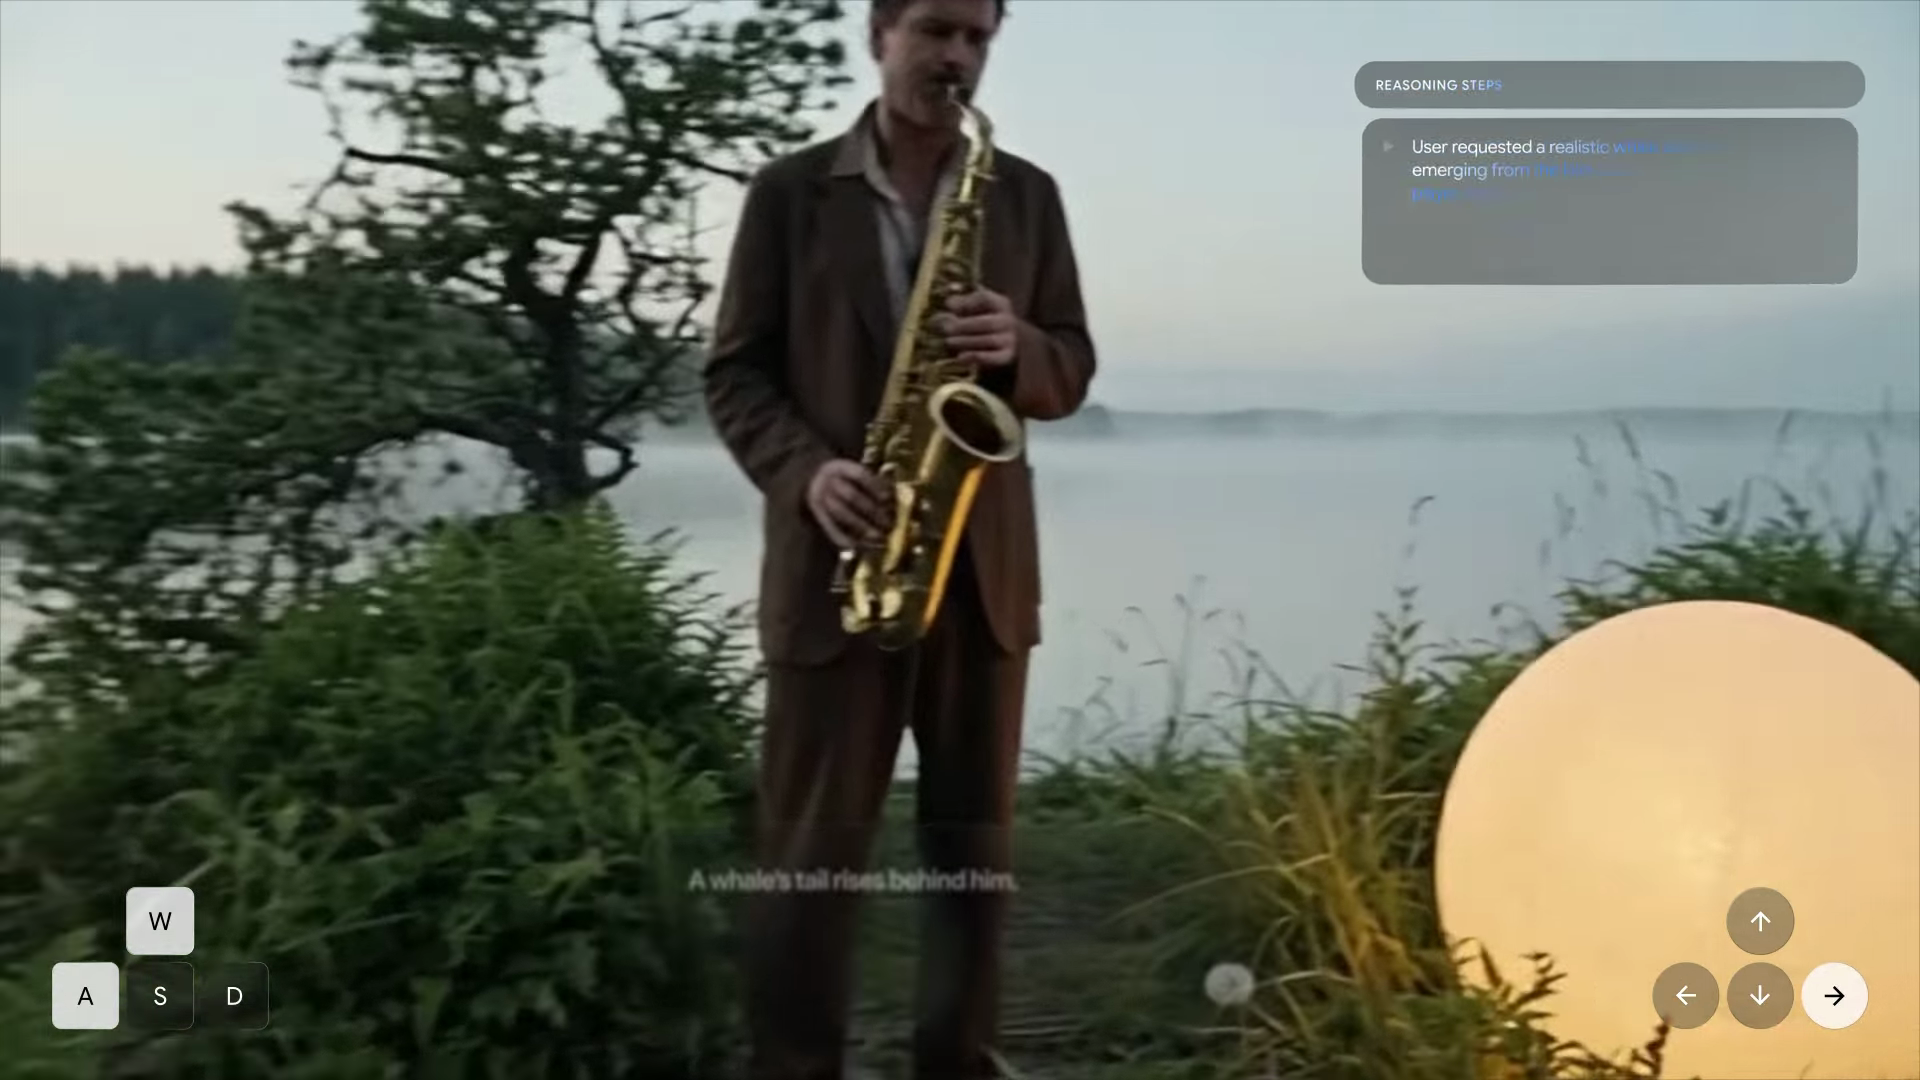
想象你站在一片湖边。一个穿棕色西装的人吹着萨克斯,风从水面过来。
你打了一行字:"让一条鲸鱼从湖里浮出来。"
鲸鱼尾巴真的从水里升起来了,水声跟着变了。萨克斯没停,画面没断,你还能用 WASD 走过去换个角度看。
这不是剪出来的一段视频。是一个正在实时运行的世界。
10 月 27 日,Google DeepMind 发布 Genie 4,这是它家第一个能原生生成声音的实时世界模型。
它升级了四件事
官方自己列了四条,我按重要程度重排:
1. 原生音频。 这是 Genie 系列第一次。每个世界自带它该有的环境音——风穿过树林、海浪拍岸;更关键的是交互对话:里面的人能说话,能对你的操作做出反应,实时生成,不是预录。
2. 实时改世界。 用自然语言改天气、移镜头、加一个人或一个物体。Gemini 会结合周围场景改写你的指令,让它接得上;你不说话的时候,它也在后台盯着,推着世界往前走。
3. 物理和人物。 官方说 Genie 4 模拟空气动力学、碰撞这些真实物理;人物动作是这次最大的跃升——会自然地走、对环境做出反应、能被实时操控。
4. Gemini 当导演。 这是最容易被忽略、但最重要的一条。
后台有个 Gemini 在盯场
Genie 4 不是一个人在干活。
官方写得很清楚:Gemini 3.8 Flash 在循环里当引导 agent——它持续观察 Genie 生成的画面,把目标拆成一步一步,再回看新生成的帧,确认这一步有没有做成。世界变了、你插了一句话,它当场改计划。
再往上,Gemini 4 Argon 负责把任务拆成步骤,这些步骤以文字字幕的形式,在渲染过程中不断喂给 Genie 4。
所以它不只是"生成画面",而是一边生成、一边检查、一边纠偏。
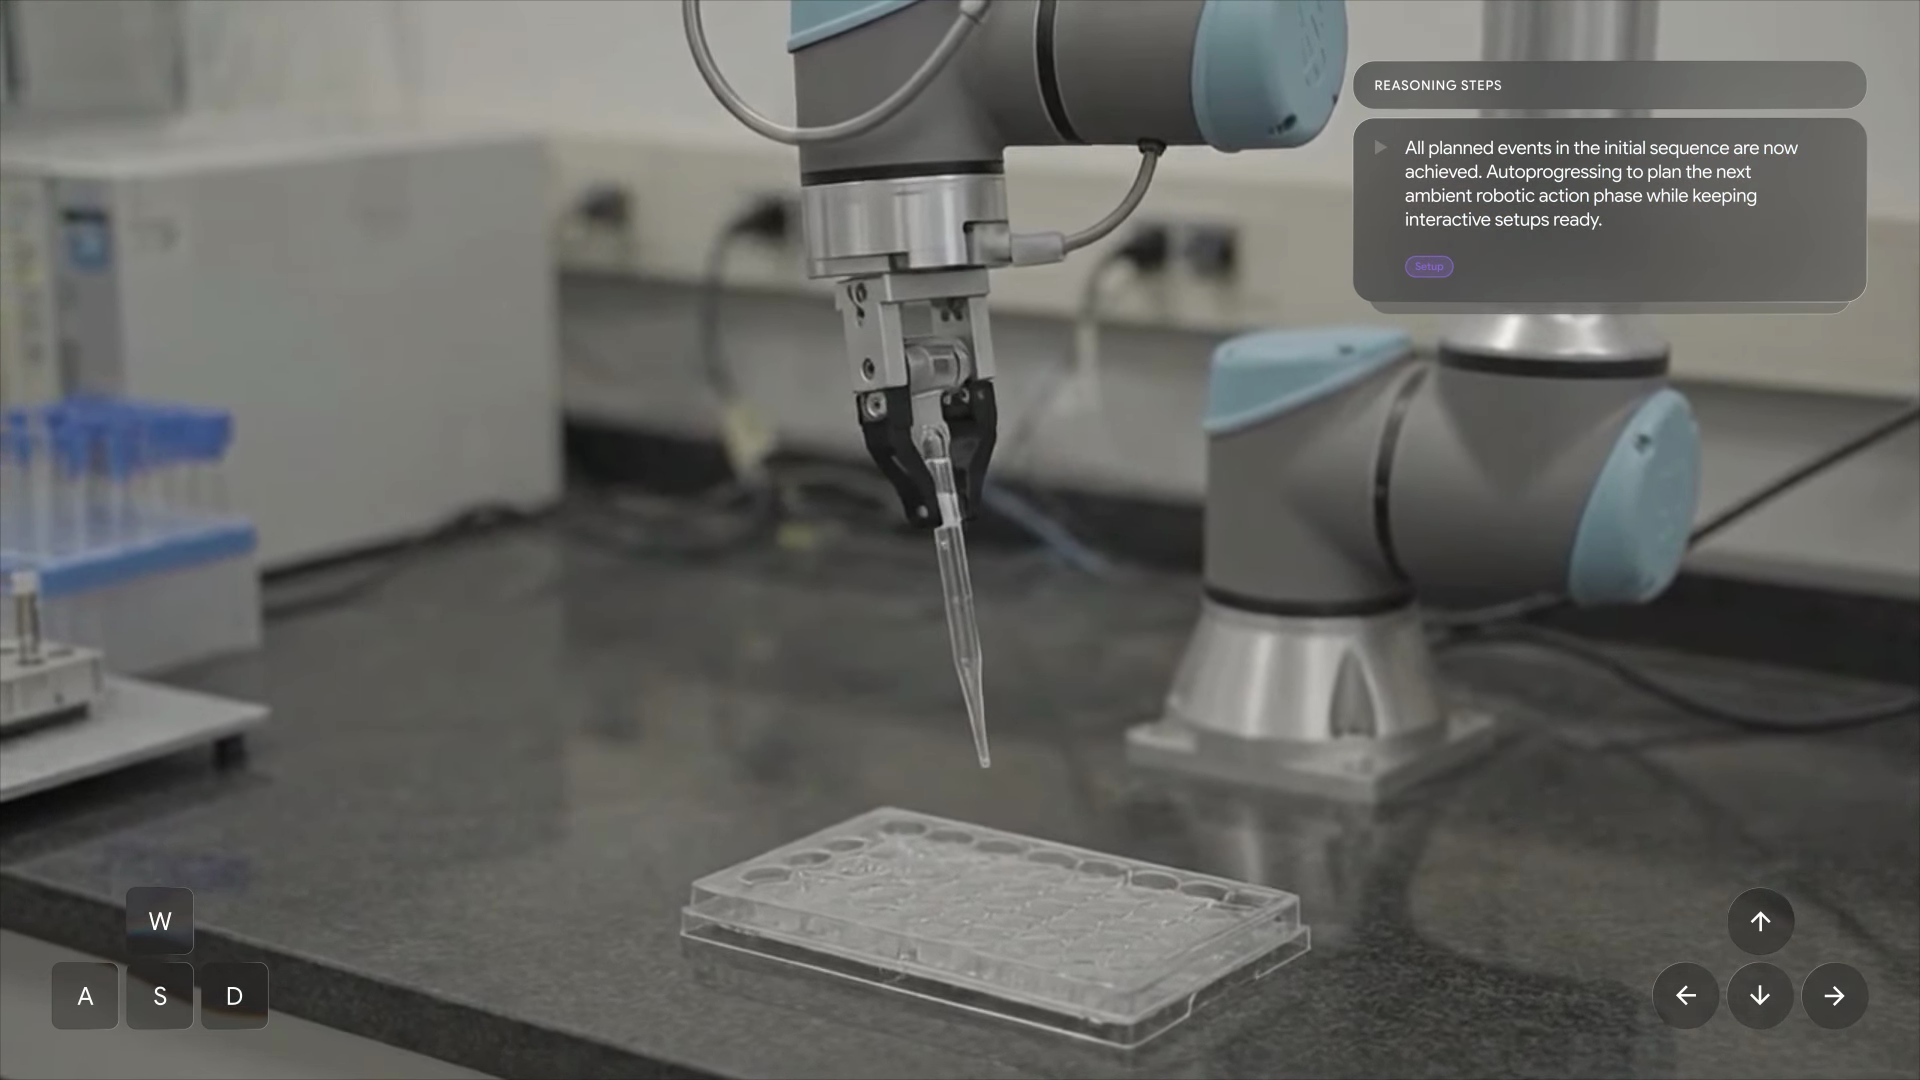
这张图更能说明问题:一个机械臂在虚拟实验室里做液体处理,右上角的"REASONING STEPS"写着"初始序列的计划事件都已完成,正在规划下一个环境机器人动作阶段"。
这就是世界模型真正的客户——不是拍短视频的人,是要训练机器人和 Agent 的人。
和 Genie 3 比,差在哪
Genie 3 是去年 8 月的产品,官方参数是 720p、20–24 帧、能连续交互几分钟、靠 Google 街景做现实锚定。
Genie 4 官方没有公布分辨率和帧率,也没说能撑多久。它明确加的是三样:声音、人物、推理。
有个细节值得注意:Genie 3 的局限里写着"可读文字只在输入描述里出现时才清晰",Genie 4 的局限里仍然写着"渲染清晰文字"是待研究方向。一年过去,这块没解决。
它能用来干什么
官方给了四类测试者场景,都不是"生成一段好看的视频":
电影预演。 导演走进一个实时场景,现场改机位、灯光、台词、动作,一条一条"走拍",不用等渲染。
新闻照片复原。 一张 2D 历史照片,几秒钟变成一个能走进去的环境;也可以模拟山洪、野火这类短时事件怎么蔓延。
游戏原型。 从想法到可探索的 demo,几分钟;先试视觉风格和交互机制,再决定要不要写引擎代码。
机器人与企业仿真。 生成训练场景,让 Agent 在进入真实世界之前先在里面跑。
这四类有个共同点:要的是"能改、能反复试",不是"能发朋友圈"。
丑话:门只开了条缝
1. 你大概率用不上。 现在是研究预览,只发给 trusted testers。之后才轮到 Google AI Ultra 订阅者在 Project Genie 里用,以及 Gemini API / AI Studio 的早期合作方。想试先去排 waitlist。
2. 没有价格,没有 API ID,没有公开基准。 官方一个字没提收费。第三方平台上(OpenRouter、models.dev)也查不到。所有"它比谁强"的说法,目前都只能引用谷歌自己的演示。
3. 官方自己列了一串没解决的问题。 物体恒存会漂移——尤其是跑久了、连续做复杂编辑之后、或者在场景里走远之后;复杂物理交互、实时音频准确性、可读文字、空间准确性、长期一致性,全是"ongoing research"。
翻译一下:短时间看着很神,时间一长、改得越多,越容易崩。
4. 所有输出都带 SynthID。 视频和音频都嵌了不可见水印。想拿它造假新闻,技术上会被标记。
5. "两分钟一致性"是媒体说法。 有报道说 Genie 4 能保持约两分钟一致、是前代两倍,但官方博客只写了"short sessions",没给具体秒数。这种数字引用时得留个心眼。
我的判断
世界模型这条线,正在分成两种生意。
一种是做内容:Sora、Veo、可灵,产出的是给人看的视频,卖订阅、卖时长。
另一种是做环境:Genie、World Labs,产出的是能交互、能试错的空间,卖给做 Agent、做机器人、做仿真的人。
Genie 4 把声音加进来,不是为了让你听见海浪,是为了让具身智能体学会"声音和动作有因果关系"——玻璃碎了会响,响意味着有东西坏了。这是训练里必须有的信号。
所以它现在的形态很合理:不开放、不定价、只给少数人。因为它还不是产品,是训练场。
对普通人,这一代世界模型还远——你打开网页,看到的是一个模糊的、会漂移的、只能撑几分钟的梦。
但对做机器人、做游戏原型、做影视预演的人,门缝里透出来的光已经够亮了。
真正的问题是:当"世界"可以随时生成,稀缺的就不再是画面,而是你决定让这个世界发生什么。
相关链接:
暂无评论。