英伟达和 Pika 都在改这个中国模型,但美国用户不能本地跑
10 月 29 日,Pika 发布 H3 Flex。
不是新架构,是两个 LoRA 适配器,挂在 MiniMax 的 H3 上。六步出片,15 秒视频带立体声,最高 4K,DesignArena 文生视频榜第七——比它挂靠的底座 H3 还高。
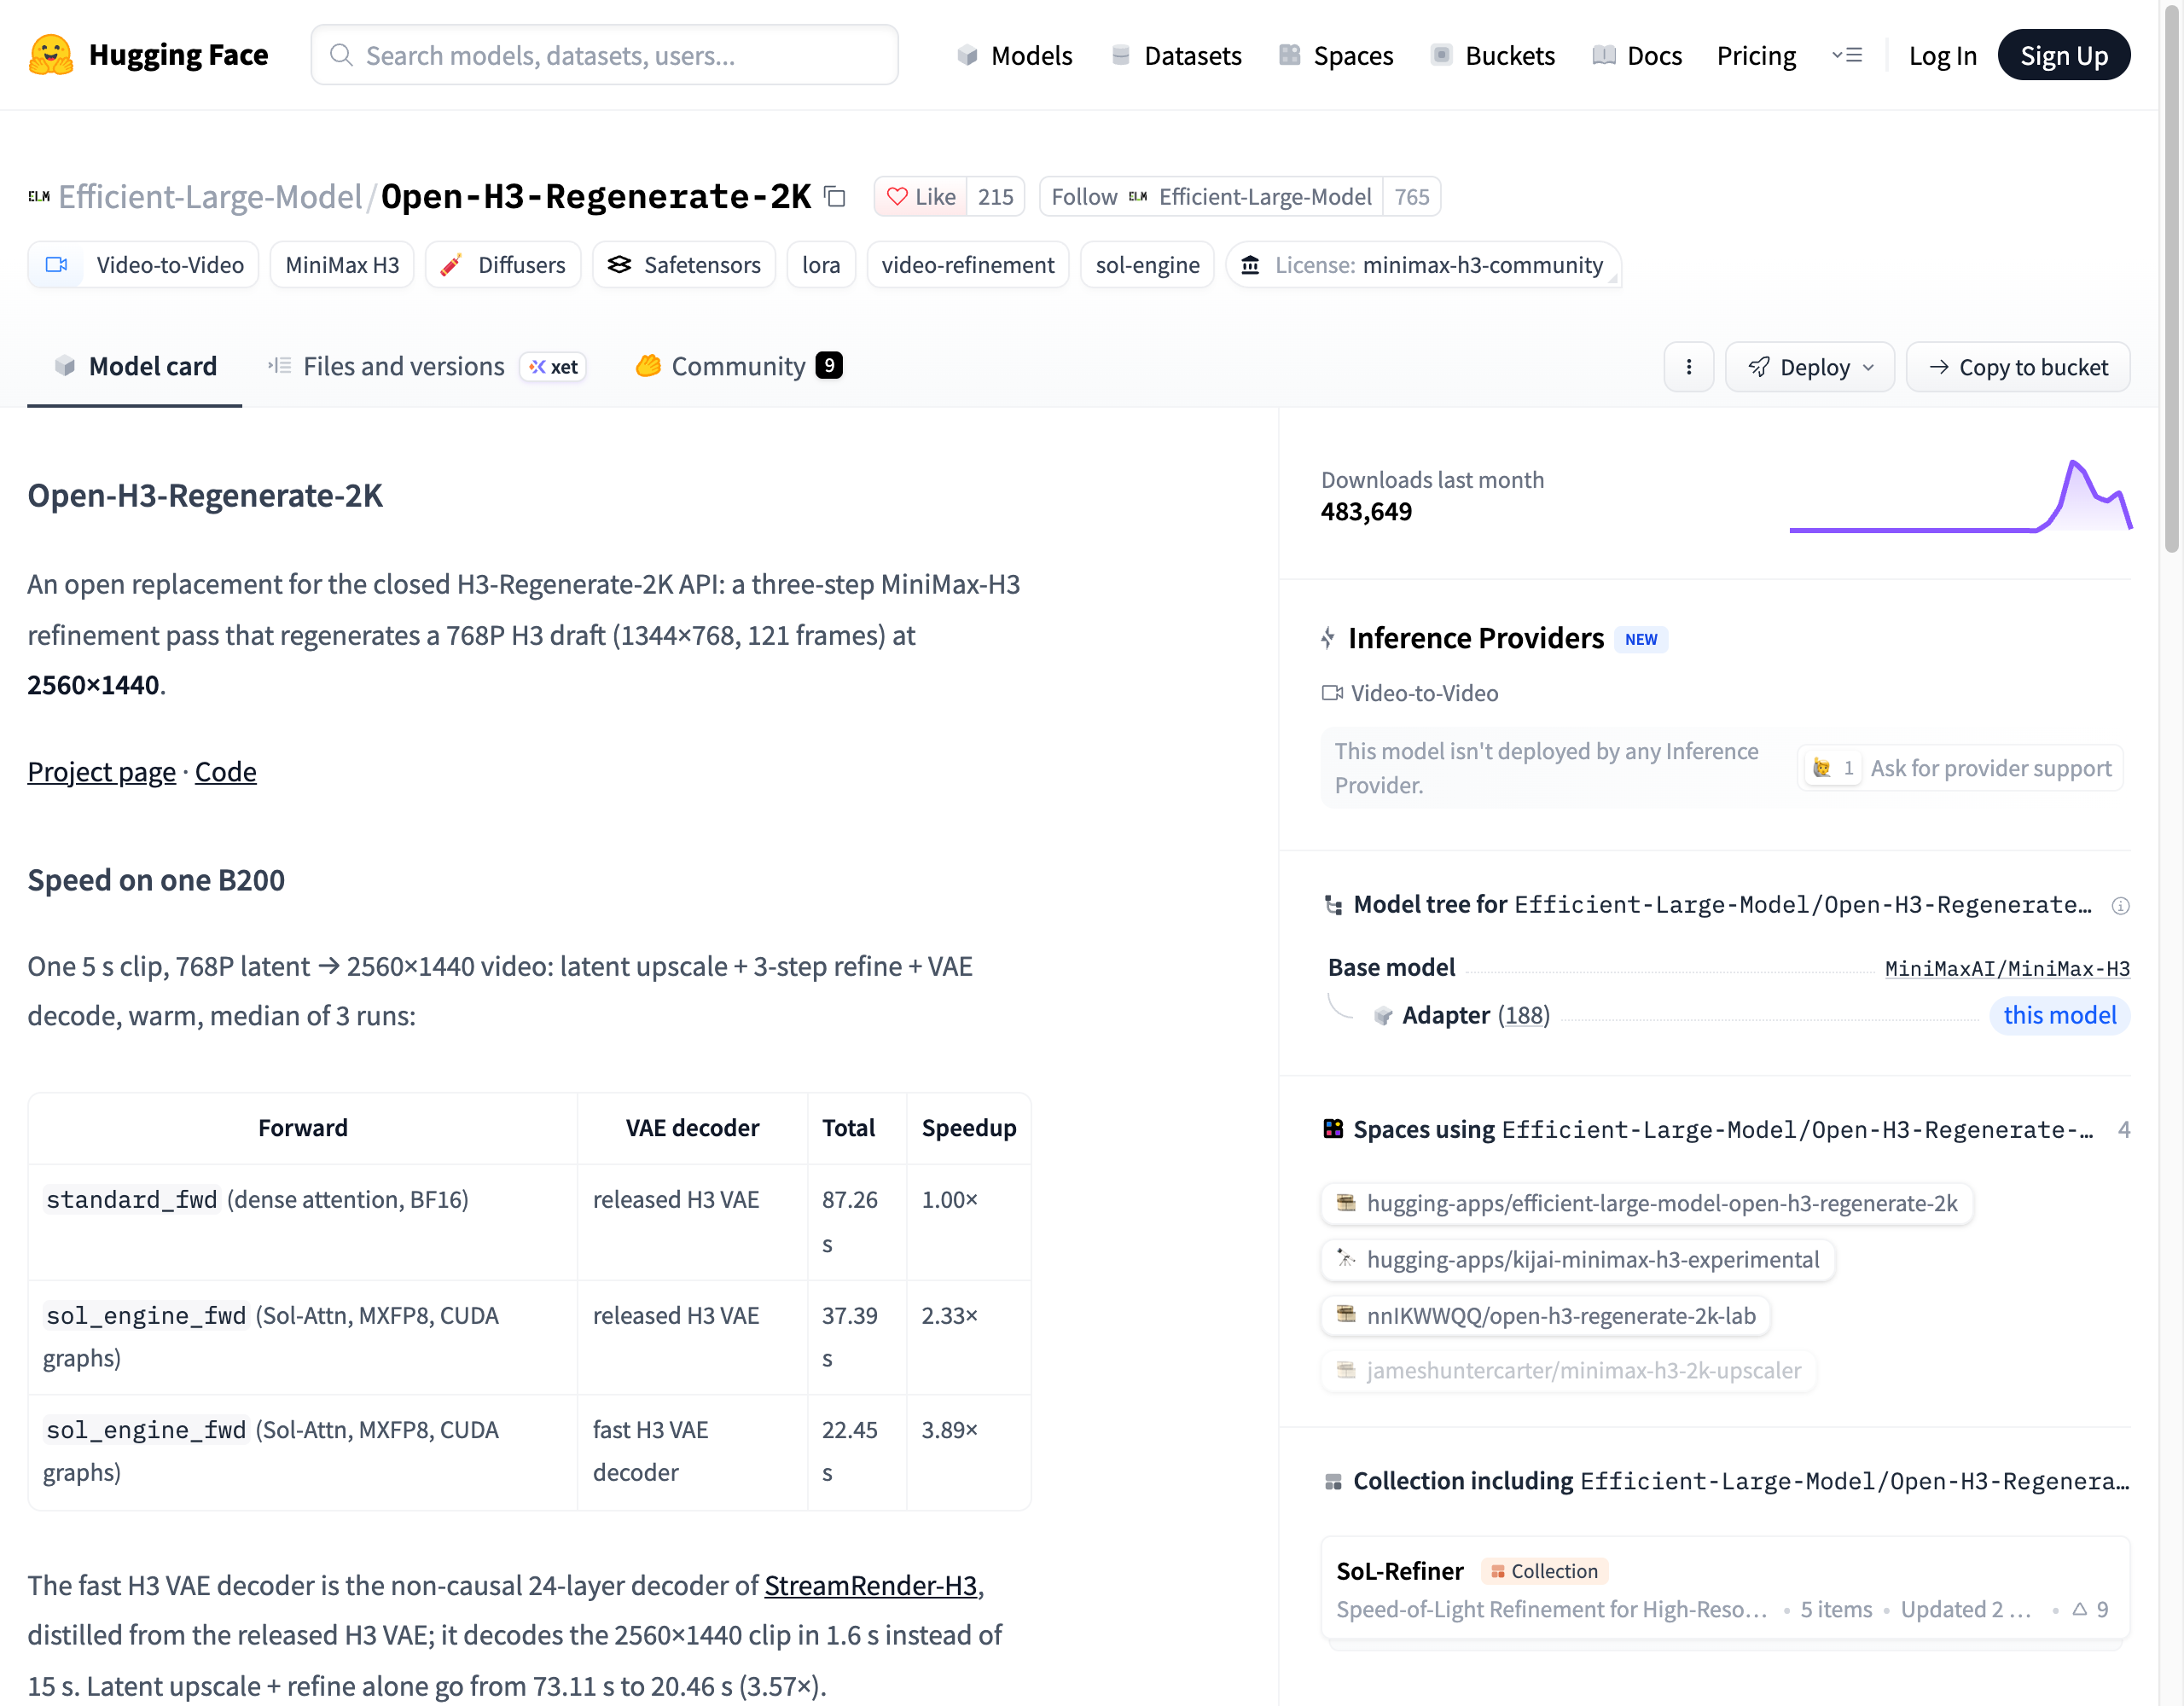
紧接着,英伟达和 MIT 的 Efficient-Large-Model 团队放出另一份权重:Open-H3-Regenerate-2K,把 768P 的视频草稿重生成到 2K,最高 4K。
两个团队,一个在硅谷做产品,一个在实验室做增强,选的是同一个底座。
然后它们都撞上了同一件事:H3 的社区许可证,把美国排除在"本地部署"之外。
两个团队,同一个底座
先说底座。
MiniMax H3 今年 8 月开放权重。它是个"全模态生成"模型:视频和音频一起出,2K、15 秒、原生双声道。开放的是 H3-Base(768P 音视频),更高分辨率的 H3-Regenerate-2K 走官方 API。
开放一个月,下载量超过 2400 万次,公开衍生模型 300 多个。按智通财经的说法,H3 是 2026 年全球下载量最高的模型之一。
下载量不等于质量,但 300 个衍生模型说明一件事:它成了别人做二次开发的默认起点。
Pika 改了哪里
Pika 没有重训架构,做的是三件事:在一个精选的多任务数据集上做后训练(视频、音频、参考任务),把 50 步的教师模型蒸馏到 6 步,再用奖励反馈和偏好优化收一遍。
成品拆成两个适配器:
- FL2VA:文生音视频、首帧、尾帧、首尾帧四种模式
- Ref2VA:最多 12 个多模态参考(9 张图、3 段视频、3 段音频),可以锁人物、服装、物体形状、环境、运动,甚至声音
规格上,5 到 15 秒、24fps、32kHz 立体声,最高 4K,能导出 5 条独立音轨。官方说 15 秒 768P 的视频,DiT 去噪最快 7 秒——比实时还快。
代价是硬件:本地跑要 H3 底座,权重下载约 215GB,官方在单张 H100 80GB 上测的。
英伟达改了哪里
英伟达和 MIT 这条线更"工程":不做生成,做重生成。
输入一段 768P、121 帧的草稿,先用潜空间放大器把 latent 直接放大,再用三步去噪在目标分辨率上重画细节。H3 的 Transformer 主干和视频 VAE 参数全部冻结,只训新增的细化 LoRA。
配的是自家加速栈:Sol-Attn 稀疏注意力、MXFP8 低精度、CUDA graphs,再加一个从 H3 VAE 蒸馏出来的快速解码器。
在单张 B200 上,一段 5 秒视频的放大 + 三步细化 + 2K 解码:87.26 秒降到 22.45 秒,3.89 倍。其中解码从 15 秒压到 1.6 秒。
画质上,团队在 RefinerBench-150 上对比官方 API:感知质量 UniPercept 60.0 对 53.4;VBench 的美学质量、成像质量、主体一致性更高,官方 API 在运动平滑度和动态程度上仍略好。
分工变了
以前的分工是:中国团队追 SOTA,硅谷定义产品。
现在的分工是:底座在中国,产品在硅谷,许可证在中间收租。
这不是"中国模型赢了"那么简单。底座是重资产——几万张卡、几个月训练、一次失败就是几千万美元;后训练是轻资产——两个 LoRA、一个蒸馏、几周时间,就能做出一个在榜单上比底座更高的模型。
Pika 和英伟达做的事,本质上是把"训练"换成了"改造"。这件事之所以成立,前提是有人愿意把底座开源。
而开源的代价,写在许可证里。
许可证那页,写着四个地名
MiniMax H3 的社区许可叫 MiniMax H3 Community License Agreement,2026 年 8 月 2 日由 Nanonoble Pte. Ltd. 发布。
核心条款四条:
- 地域:授权范围是"全球减去四个排除地区"——欧盟、英国、韩国、美国。也就是说,这四个地方不能本地部署。
- 收入门槛:年收入超过 2000 万美元的商业产品,需要 MiniMax 书面许可。
- 署名:商业产品或服务必须在界面上显眼地标注"MiniMax H3"。
- 禁止蒸馏:不能用模型或其输出去改进另一个 AI 模型——那条"生成合成数据训自己的模型"的路,被堵死了。
MiniMax 对输出不主张权利。这一点比很多"开源"许可证干净。
排除四地的理由,官方也写了:欧盟 AI 法案已经开始适用,但视频和肖像生成的实操要求还在变;英国、韩国类似;美国则是监管变化快,加上 MiniMax 自己正面临一桩生成视频的版权诉讼。
结果很微妙:
- Pika 的推理代码是 Apache 2.0,随便用
- 但适配器继承 H3 的社区许可,因为 Pika 自己说它们是 H3 的"模型衍生品"
- 于是一个美国公司做的开放权重模型,美国用户不能在自己机器上跑,只能通过托管服务用
英伟达那条线同理:权重开放,代码在 NVlabs/Sana,但许可跟着 H3 走。
这条许可到底卡住了谁
对研究者,卡的是"本地复现"。你可以读代码、看论文、调 API,但不能在自己机房里把权重跑起来——而很多评估恰恰需要离线、可重复的环境。
对创业公司,卡的是"成本结构"。托管按秒计费,Pika 公布的价格是 480P 每秒 1 美分,4K 每秒 8 美分;自建是一次性买卡,边际成本接近电费。许可把这扇门关上了,等于把"重资产"重新推回给平台。
对国内团队,反而没这条限制。中国不在排除区,自建 H3、微调、商用(只要不碰 2000 万美元门槛和署名条款)都走得通。
所以你会看到一个有点荒诞的场面:一个中国模型,在中国最好用;在美国,只能租。
开源卖的不是钥匙,是门票
这两年"开源"被说成一种立场:开放、共享、对抗闭源巨头。
H3 这页许可证提醒我们,它更像一张门票:让你进门,但门开在哪、开多久、谁能进,写在发门票的人手里。
这不一定是坏事。MiniMax 把最贵的部分(底座训练)免费给了社区,换来了 2400 万次下载、300 个衍生模型和整条生态的默认位置;Pika 和英伟达省下了几个月的训练时间,做出了榜单更高的产品;用户多了两个能用的模型。
但"开源"不等于"没有条件"。下次再看到这两个字,先翻到许可证那页——那里写着你能不能在自己的机器上跑,能不能商用,能不能拿它去训下一个模型。
底座可以借,规则得自己看清。
相关链接:
- Pika H3 Flex 发布:https://pika.art/blog
- Open-H3-Regenerate-2K 权重:https://huggingface.co/Efficient-Large-Model/Open-H3-Regenerate-2K
- 推理代码(NVlabs/Sana):https://github.com/NVlabs/Sana
- MiniMax H3 官方:https://www.minimax.io/
暂无评论。