出题的和解题的是同一个 AI,20.7 分的模型自己练到 63.6
健身的人都懂一个铁律:配重太轻,做一百次也不长肌肉;配重太重,直接受伤退赛。真正的进步发生在"刚好力竭"的那组重量上。AI 训练圈最近把这条铁律搬进了自博弈——阿里 Qwen 团队开源的 Skill Self-Play,让模型自己出题、自己解题、自己编教材,而整套系统的灵魂只有一句话:把题目的难度,死死锚定在模型的"刚好力竭"线上。
效果有多离谱?同一个 Ministral-3-8B 模型,工具调用准确率只有 20.7 分,几乎不会按格式调工具。常规的自博弈练 5 轮,涨 0.1 分,等于没练。换上 Skill-SP,同样 5 轮、同样基座、没有任何更强的外部老师,冲到 63.6 分。
自博弈的死胡同,卡在哪
先说背景。让 AI 自己教自己(self-play)是这两年的热门路线:AlphaZero 靠它横扫棋类,Absolute Zero 证明了语言模型也能零数据自我进化。但路线很快撞上两堵墙:环境绑定的方法(写代码、跑测试)反馈精确,可学的东西太窄;放开让模型自由出题,任务五花八门,却没法验证对错——错误的奖励一旦混进训练循环,整套系统就在污染里越陷越深,这个坑有个专门的名字,reward hacking。自博弈的前辈们在这两堵墙之间反复横跳,代价是模型多样性坍缩。
Qwen 团队的判断是:缺一个中间层。既要有足够的广度,又要每道题都验得了。他们选中的,是 Anthropic 在 2025 年带火的 agent skill——但用法和所有人都不一样。
把 Skill 从提示词塞进训练循环
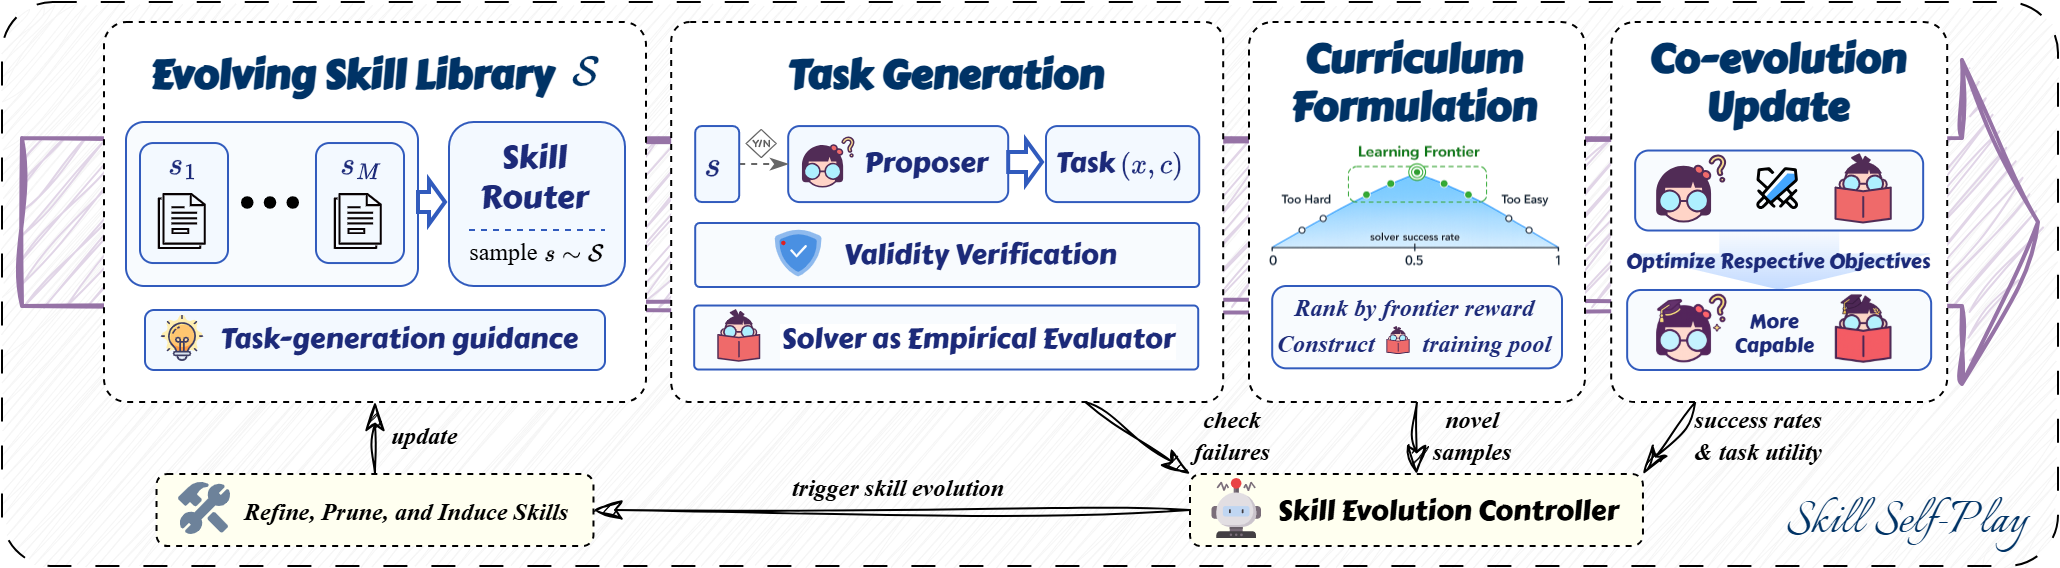
过去一年,大家把 skill 当成推理时的小工具:模型用到哪个加载哪个,本质是给上下文塞说明书。Skill-SP 做的事是把技能挪进训练循环,当成"课程引擎"。在它的定义里,一个技能包不只是说明书,而是六件套:路由元数据、规则、生成提示、few-shot 示例、可执行验证器,外加历史统计。
整套系统三个角色一起滚:出题者(Proposer)按采样的技能生成任务;解题者(Solver)做题、被训练;技能控制器(Skill Controller)盯着执行轨迹,改写失灵的技能、淘汰只出简单题的技能、把探索出来的新玩法归纳成新技能。5 轮下来,活跃技能从零涨到 86 个。
对应到健身房的隐喻:技能库是课表,出题者是按课表配重的教练,解题者是练的人,控制器是定期调整课表的私教主管。而"刚好力竭"这条线,被写成了一个极简的奖励公式——任务成功率越靠近 0.5,出题者拿的奖励越高。太简单的题(成功率 0.7+)和太难的题(0.3 以下)都不值钱。实测数据也印证了这点:技能流出的题平均成功率 0.57,稳稳贴着学习前沿;无引导自博弈出的题漂到 0.70,全在划水。
防作弊的设计藏在前半段:出题者的奖励前面挂了一个"任务有效"硬门控,直接把无解任务判零分。没有这个门控,出题者会发现刷分的捷径——专门生成模型永远解不出的难题,让成功率恒等于 0,坐收"难度拉满"的奖励。这个漏洞正是 Absolute Zero 类系统被诟病的地方,Skill-SP 用一个乘法门控堵死了它。
数字:5 个基座,全线提升
官方 README 摆出的主结果,覆盖 3B 到 14B 五个基座、两类可验证任务:
| 基座 | 工具调用 | 提升 | 逻辑推理 | 提升 |
|---|---|---|---|---|
| Qwen3-4B | 60.2 → 66.7 | +6.5 | 72.1 → 73.5 | +1.4 |
| Qwen3-8B | 69.4 → 72.2 | +2.8 | 23.6 → 32.4 | +8.8 |
| Ministral-3-8B | 20.7 → 63.6 | +42.9 | 5.0 → 11.2 | +6.2 |
| Ministral-3-14B | 22.2 → 64.5 | +42.3 | 5.4 → 17.4 | +12.0 |
| Granite-4.1-3B | 57.2 → 62.5 | +5.3 | 11.6 → 12.6 | +1.0 |
最刺眼的是 Ministral 两个型号的三倍翻盘。原因有点残酷:无引导自博弈在 8B 上完全启动不了——基座太弱,连合法任务都生成不出来,训练循环直接饿死;Skill-SP 的技能引导等于扶着它出题,硬生生把学习信号逼了出来。消融实验也验证了每个部件都在出力:冻结反馈用的解题者掉分最狠(-3.0),说明出题者必须跟着解题者一起进化,课表才能始终锚定在前沿。
但翻盘有边界。逻辑推理上,最难的 Large/X-Large 谜题,弱模型几乎零提升——太弱的模型自己造不出高难好题。自博弈存在"最低能力门槛",它放大长板,救不了不能自省的短板。
三盆冷水
第一,这是一篇论文的代码仓库,不是产品。GitHub 上 145 星、8 个 fork、0 个 issue,唯一的提交记录是 7 月 27 日的 "Initial public release",一个贡献者。热度与"神级"的民间评价之间,隔着一个巨大的实践空窗。
第二,自博弈不省钱。README 写得明白:训练按 8 张 GPU 起步,出题者占 4 卡,解题者占满 8 卡,还要求 CUDA、vLLM、FlashAttention 自行配平。个人玩家能在本地跑通推理,跑不通这套训练。所谓"没有外部老师",省的是标注和人类反馈的钱,不是算力的钱。
第三,翻盘叙事要看背景。Ministral-3 是 Mistral 的 Apache 2.0 开源模型,"对齐坏掉"更可能是训练侧重点不同,而非模型残缺——被救回来的 63.6 分,依然低于 Qwen3-8B 练之前的 69.4。它是让弱模型及格的技术,不是点石成金的魔法。
真正值得记住的一件事
抛开分数,这篇论文的范式意义在于位置:skill 从推理时的提示词,挪到了训练时的课程引擎。练完即走——技能只在训练期使用,最终的解题者推理时就是普通的 prompt-only 模型,零额外开销,部署侧什么都不用改。
这意味着自进化的成本结构变了。以前想提升模型能力,要么堆人类标注,要么堆更强的教师模型蒸馏;现在,一条"自己出题、验证、锚定前沿"的闭环第一次被完整走通。出题的和解题的是同一个 AI,教练也是它自己——健身房 24 小时营业,不请私教。
剩下的悬念只有一个:课表还能进化多久,才会碰到它自己够不着的重量。
相关链接:
暂无评论。