Agent 又忘了你的偏好?腾讯给它盖了座四层档案楼
大多数 AI 记忆系统干的是同一件事:把聊天记录压成一段摘要,下次对话塞回去。腾讯这套开源的记忆系统反着来——原文一个字不动,全存下来。更反直觉的是,这个看起来更费钱的方案,把长任务的 Token 账单砍掉了 61%。
它叫 TencentDB Agent Memory,腾讯云数据库团队 4 月开源,5 个月做到 2.6 万星,登顶过 GitHub Trending 日榜第一。Datawhale 上周发了一篇实测长文,我把它和官方仓库对着读完,把这套系统真正值得聊的东西拆给你。
先说清楚:为什么摘要式记忆是错的
你肯定遇过这种事:纠正过一次的毛病,AI 下次照犯;说过的偏好,新会话清零。这不是模型笨,是记忆被处理坏了。
摘要式记忆的死穴在"不可逆"。原文压成摘要的那一瞬间,细节就没了——你没法从摘要里查证"用户当时到底说的 6 点还是 7 点"。而一旦摘要压错了重点,错误会被每一轮对话继承,还查不出错在哪。
腾讯的方案是把记忆盖成四层楼,每层干不同的活:
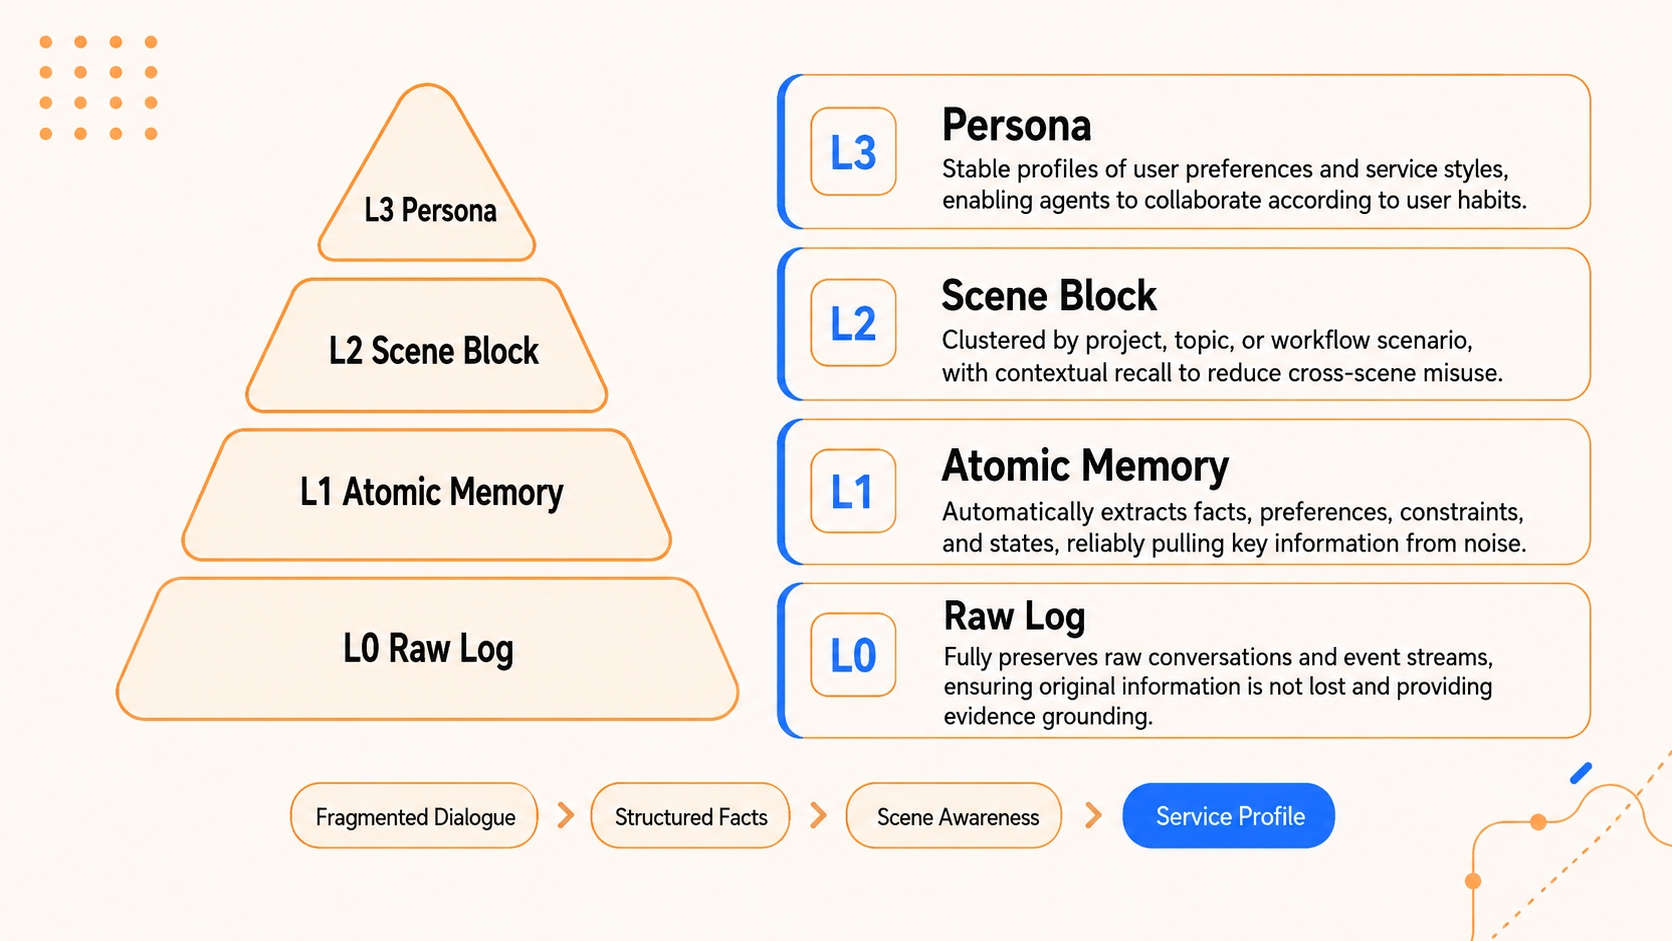
- L0 原始对话:流水账,一字不改全量落盘。这是凭证室,保的是证据;
- L1 原子记忆:从对话里抽出结构化事实,一条只记一件事,分偏好、事件、规则三类。这是卡片柜,保的是精度;
- L2 场景档案:同一情境的卡片打包成册,按项目组织、不按日期,每被命中一次热度加一。这是档案架,保的是情境;
- L3 用户画像:从所有场景里蒸馏出的稳定画像,每轮对话无条件注入。这是门口那张名片,保的是效率。
关键设计在"打通":名片不合适?顺着它下楼翻卡片柜,卡片带着来源标记,一路能追到凭证室里的原始对话。平时用高密度摘要省 Token,出了分歧下楼查原文——压缩不再牺牲证据,官方管这叫"可下钻链",白盒可查,记忆不再是黑盒。
数字:四项基准,Token 全线下降
光看架构是好听,README 里摆了四项基准,全是在连续长会话里测的(SWE-bench 每个会话连跑 50 个任务,模拟真实长任务的压力):
| 基准 | 裸 Agent | 带记忆后 | Token 变化 |
|---|---|---|---|
| WideSearch(长任务) | 33% | 50% | 221M → 86M |
| SWE-bench(编程) | 58.4% | 64.2% | −33% |
| AA-LCR(长上下文) | 44.0% | 47.5% | −31% |
| PersonaMem(个性化) | 48% | 76% | — |
两个值得多看一眼的数字。一是 PersonaMem 从 48% 到 76%:这类学术基准上,通用记忆方案常年趴在 50% 上下,跃升 28 个点说明分层结构对"跨会话个性化"这件事是真实有效的。二是 Token 降幅最大的是 WideSearch:长任务里最烧钱的从来不是对话本身,是几十轮工具调用的中间日志——系统把这些日志转存成一张轻量的 Mermaid 任务图,上下文里只留地图,要看细节再按编号回查原文。这一手单独拎出来,就值回票价。
实测里最有价值的一个坑
Datawhale 的实测部分,时效、提炼质量都算漂亮:说完一句话,毫秒级落盘,后台约 6 秒提炼成卡片,10 秒内可检索,自然聊天几乎无感。但真正值钱的是他们踩出来的那个坑——
他们存了一条"完全不能吃辣",然后用八种说法去查:带"辣"字的都能命中,"川菜""忌口""spicy food"全军覆没。原因是语义召回默认关闭,零配置跑的其实是关键词匹配——查"川菜"当然找不到"不吃辣"。
更深一层的坑在配置语义:策略默认值写的是混合检索,语义能力默认值却是关——两个默认值凑一起,混合检索实际降级成纯关键词。你以为开着混合,其实只跑了一半。
我把这个坑和 GitHub 的 issue 区对了一下,发现它不只是开关问题:issue #1363 直接写着,SQLite 后端下 hybrid/embedding 模式"声明有效但实现缺席"。也就是说在本地默认配置里,语义检索不是"没打开",是"还没到"。想让 Agent 听懂自然语言表达的偏好,要么接远程 embedding 服务,要么等实现补齐。
泼冷水:这些数字该怎么读
第一,上表全部出自官方自测,利益相关。第三方论文里,同类分层方案 O-Mem 在 PersonaMem 上报 62.99%,说明 76% 并非行业天花板,复现结果值得等一等。
第二,热度不等于采用。2.6 万星很猛,但 npm 包周下载只有 1566——看的人远多于用的人。770 个 open issue、13 位贡献者,项目还在快速修补期,v2.0 系列上个月才发稳定版。
第三,记忆系统的通病它也没根治。有个叫 PrecisionMemBench 的评测专门测"记忆系统返回错误答案的精度",结果惨烈:向量基线 0.09,Mem0 0.05,Zep 0.08——这个赛道最危险的不是查不到,是自信地查错。四层楼加白盒调试正是冲着这个去的,但只要开了语义召回,你的对话原文就会被送去做向量化,隐私敏感的场景先掂量。
第四,冲突仲裁靠模型判断。你说"改用 MySQL"时,系统会翻出旧卡片让模型判断是改口、并存还是矛盾——判断质量取决于召回质量,没召回到的旧偏好,在它眼里等于不存在。
放进记忆赛道里看
| 方案 | 定位 | 适合谁 |
|---|---|---|
| Mem0 | 可插拔记忆 API | 已有框架,加层记忆就走 |
| Letta | 完整 Agent 运行时 | 从零建 Agent 原生应用 |
| 腾讯这套 | 分层记忆 + 本地白盒 | 长会话重任务,想查证记忆来源 |
想上手的话门槛不高:OpenClaw 一条命令装插件,零配置默认本地 SQLite;Hermes 有 Gateway 镜像和手动接入两条路(要求 Node 22.16+);自研项目直接引用包。一个决策点提前想清楚——只记格式规范、工具偏好这类说法固定的东西,不用开语义召回;要理解"我不能吃辣"和"川菜推荐"的关联,必须开。
我的判断是:这套系统真正的看点不在腾讯,在"记忆层下沉"这个动作本身。向量化、相似度检索、重排序,去年还得自己在应用层搭,现在变成了数据库安装时的一个选项。就像当年 ORM 把 SQL 包进了代码,记忆正在从应用的功能,变成 AI 的基础设施。
而基础设施的好处是:你不用再操心它怎么工作,除非它记错了——好在这一次,楼下的凭证室里,原话一个字都不少。
相关链接:
暂无评论。