DeepSeek 掀了桌子,现在最便宜的却不是它
先看一个数字:0.4 元。
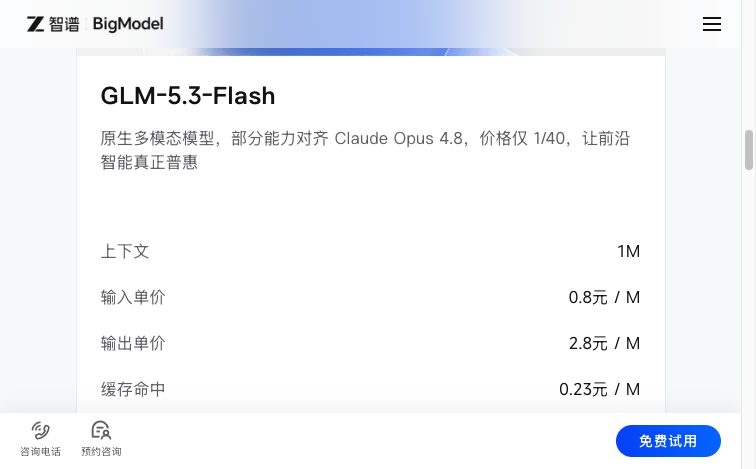
这是 GLM-5.3-Flash 现在的输入价,每百万 tokens,限时五折。换算一下,一本 100 万字的小说,大约 150 万 token,全部塞进去,输入成本 6 毛钱。
一年前,DeepSeek 用"白菜价"把整个行业的价格体系掀翻;一年后,价格表上最便宜的那一档,已经不是它了。
把价格摊开看
以下都是官方定价页的数字,单位统一成美元 / 百万 tokens(按 10 月 30 日汇率 6.65 折算):
| 模型 | 输入 | 输出 | 上下文 / 备注 |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | 272K 以内,闭源 |
| Claude Haiku 5.5 | $0.10 | $0.50 | 10 万 token 以内,超过涨到 $0.50 / $2.50 |
| GLM-5.3-Flash | $0.12(五折 $0.06) | $0.42(五折 $0.21) | 1M,原生多模态 |
| DeepSeek V4.1 Flash | $0.15 谷 / $0.30 峰 | $0.60 / $1.20 | 1M,缓存 $0.003 |
| Gemini 3.8 Flash | $0.75 | $3.75 | 1M,2027 年起翻倍 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M |
| GPT-6.1 Sol | $2.00 | $10.00 | — |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M |
| GPT-6 Astra | $10.00 | $50.00 | — |
看清楚这张表,会发现三件事。
第一件:便宜档不再是中国模型的专属
$0.10 输入、$0.50 输出——这个价位,现在站着三家:OpenAI 的 GPT-6 Luna、Anthropic 的 Haiku 5.5、智谱的 GLM-5.3-Flash(折算后 $0.12 / $0.42)。
Haiku 5.5 比上一代 Haiku 4.5($1 / $5)降了 90%。Anthropic 过去是"贵"的代名词,现在它的入门款,单价已经和国产模型在同一档。
这不是促销,是产品结构变了:旗舰模型继续卖 $10 / $50,入门模型负责抢入口。
第二件:DeepSeek 不再是价格锚点
过去两年,行业里判断"贵不贵",默认拿 DeepSeek 当尺子。
现在这把尺子有点旧了。DeepSeek V4.1 Flash 谷时 $0.15 / $0.60,比 GLM-5.3-Flash 的标准价贵,比 Haiku 5.5 的短请求价也贵;只有峰时涨价、或者上下文超过 10 万 token 之后,它的优势才回来。
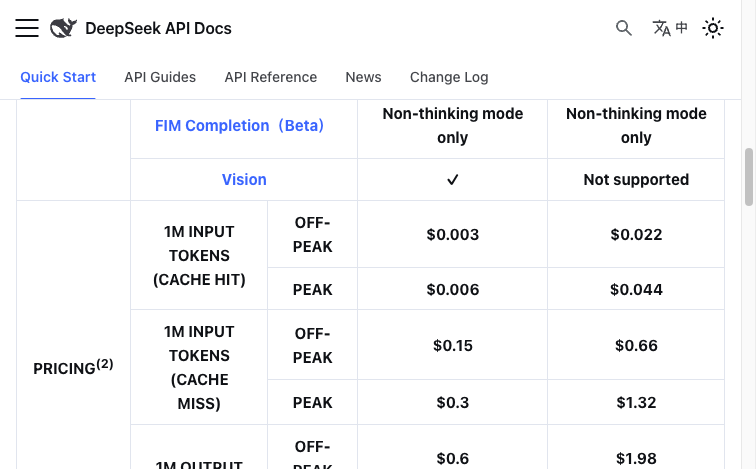
但 DeepSeek 手里还有两张牌:缓存命中 $0.003(Haiku 是 $0.01,GLM 是 ¥0.23 约 $0.035),以及1M 上下文不分档。长文档、RAG、多轮 Agent 这类"重复读同一批上下文"的场景,它的实际账单仍然最低。
第三件:"便宜"的定义变了
以前比的是单价:输入多少钱、输出多少钱。
现在得比每个任务的总成本,里面有三个变量:
1. 上下文阈值。 Haiku 5.5 在 10 万 token 以内是 $0.10 / $0.50,超过就变 $0.50 / $2.50——5 倍。你要是拿它读一份 30 万 token 的代码库,单价优势瞬间没了。
2. 缓存价格。 Agent 场景里 70%–90% 的输入是重复的。DeepSeek 缓存 $0.003,是 Haiku 的 1/3、GLM 的 1/12。同样的活,账单能差出好几倍。
3. Token 效率。 同一个任务,有的模型写 3000 token 就完事,有的要 12000。单价便宜 3 倍,token 多 4 倍,最后还是贵。
闭源厂为什么突然敢降
三个原因,一个比一个现实。
模型分层。 GPT-6 分 Astra / Sol / Luna 三档,Claude 分 Fable / Opus / Sonnet / Haiku。旗舰维持高价养毛利,小模型用低价抢开发者——反正推理成本本来就低。
推理工程。 缓存、Batch(五折)、量化、投机解码,这些优化把单位成本压下来了。价格战打到现在,拼的不是"谁敢亏",是"谁的工程效率高"。
入口之争。 一个开发者用 Haiku 写了第一个 demo,等他做大了,升级到 Sonnet、Opus 是自然路径。$0.10 的输入价,本质是获客成本。
国产模型的优势,还剩什么
单价优势在缩小,但没消失。剩下的是这四样:
- 1M 上下文不限档:GLM-5.3-Flash 和 DeepSeek 都是 1M 一口价,Claude 和 OpenAI 都按长度分档
- 缓存便宜:DeepSeek $0.003、GLM ¥0.23,适合 Agent 反复读上下文
- 开源权重:能自己部署、能微调、能离线,这是闭源 API 给不了的
- 订阅打包:$10 换 $100 额度这种玩法,本质是用模型补贴换用户,海外厂不做
换句话说:比"每百万 token 多少钱",中国模型已经不占明显优势;比"一个任务跑完花多少钱",优势还在。
怎么选,给四个场景
短请求、高并发(分类、抽取、客服)→ GPT-6 Luna 或 Haiku 5.5,$0.10 / $0.50,闭源里最便宜的一档。
长文档、RAG、代码库问答 → GLM-5.3-Flash 或 DeepSeek V4.1 Flash。1M 上下文不分档,缓存便宜,读得越多越划算。
Agent 长任务(跑几十分钟、几十轮工具调用)→ 别只看单价,看 token 效率和缓存命中率。这一项上 DeepSeek 的 $0.003 缓存价很难被追上。
批量离线处理 → 走 Batch API,Anthropic、OpenAI、智谱都是五折,Gemini 也有 50% 折扣。
我的判断
价格战没有结束,只是换了打法。
2025 年的打法是"我比你便宜一半",靠融资烧钱;2026 年的打法是"我有一档专门给你留着",靠产品分层和工程效率。前者会停,后者不会——因为 $0.10 这一档已经成了行业的基础设施价,谁撤谁丢开发者。
对开发者是好事:同样的事,成本比一年前低了不止一个数量级。
对模型厂是坏事:价格不再是护城河。当最便宜的档位上有三家、四家、五家,用户就会开始比别的东西——上下文、缓存、工具调用稳不稳、有没有开源权重。
DeepSeek 当年靠价格掀了桌子,现在它得靠别的东西留在桌上。
相关链接:
- 智谱 BigModel 定价:https://open.bigmodel.cn/pricing
- DeepSeek API 定价:https://api-docs.deepseek.com/quick_start/pricing
- OpenAI 定价:https://openai.com/api/pricing/
- Anthropic 定价:https://platform.claude.com/docs/en/about-claude/pricing
- Gemini 定价:https://ai.google.dev/gemini-api/docs/pricing
暂无评论。