2800 亿参数的模型,每次只叫醒 140 亿
11 月 5 日,百度把 ERNIE-5.5-Flash-Base 的权重放上了 Hugging Face。
280B 总参数,33.5T tokens 从零预训练,128K 训练上下文。这几个数字放在今天的开源货架上不算稀罕。真正有意思的是另一组:每个 token 只激活 14B;43 层 Transformer 里,37 层根本不逐字读全文。
它不是把 280B 全部叫醒干活,而是每次只叫醒其中一小撮,还让大多数层只看"摘要"。
43 层里,37 层只读摘要
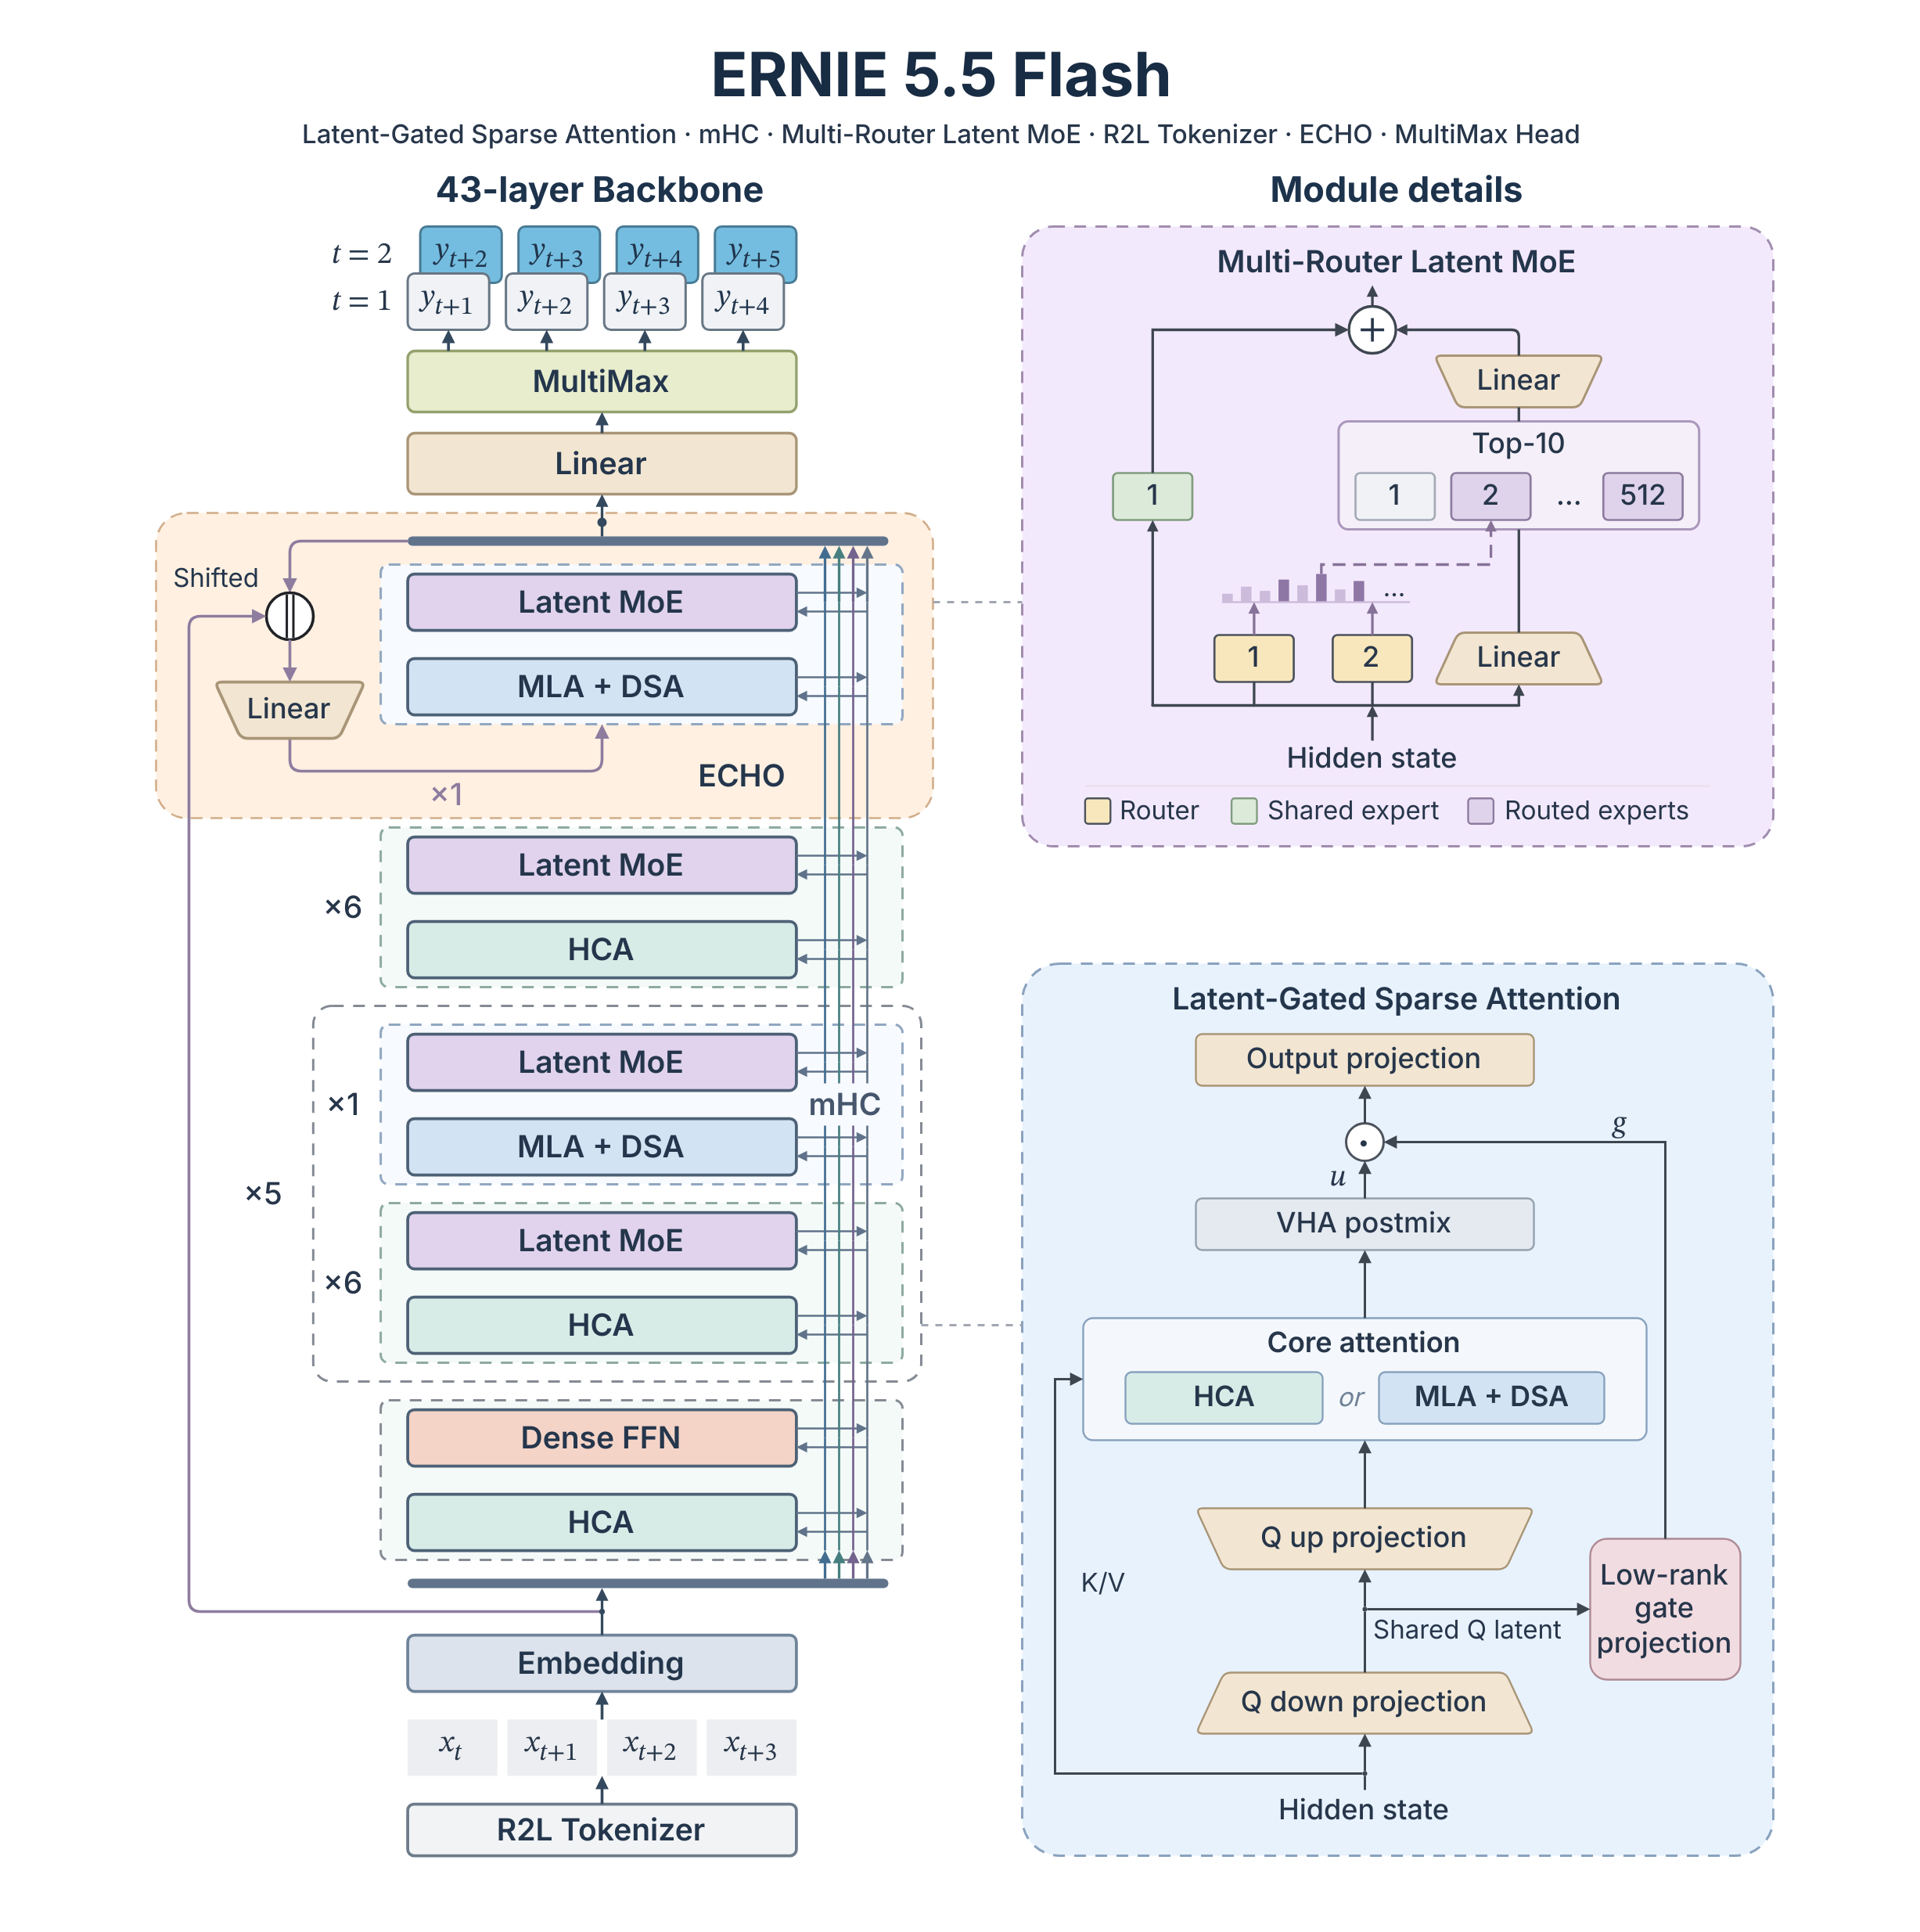
一层层拆。主干 43 层,hidden size 4096,64 个注意力头。其中 37 层用的是重度压缩注意力(HCA):每 128 个 token 压成一条缓存条目,注意力只在这些压缩条目、加上最近 128 个未压缩 token 的滑动窗口上做。
一百多页的文档丢进去,这 37 层看到的是每 128 个 token 一条的"目录",外加手边一小段原文。它不逐字读,但保住了整本书的全局视野——而且 KV cache 只有全上下文层的一小部分。
剩下 6 层才是逐 token 看历史的,用的是 MLA + DSA:一个轻量 indexer 先给每个历史位置打分,核心注意力只在 top-2048 个位置上算。这样每个 query 的注意力开销不再随上下文长度线性增长。
还有个细节挺有意思:头维度不是全模型统一的。HCA 层在 128 倍压缩后的序列上算,计算量小,就用 512 维的宽头;MLA 层要逐 token 访问,计算量大,反而用 256 维的窄头。计算便宜的层给大脑袋,计算贵的层给小脑袋——第一次见有人这么分配。
KV cache 的预算也做了取舍:他们试过把预算分给一堆压缩 4 倍的 CSA 层,最后选择集中在少数保留全部 token 的 MLA 层。在同等 KV cache 预算下,HCA + MLA 打赢了 HCA + CSA。
路由器,不止一个
MoE 的老问题是路由。传统做法是一个路由器给所有专家打分,硬 top-k 选人。百度团队在训练里观察到一件事:这个打分和专家的实际效用只是弱相关,中深层尤其明显。
更麻烦的是,落选的专家拿不到这个 token 的梯度。一旦选错,那个专家就学不到这次该学的东西,错误会自己强化自己。
他们的解法是 Multi-Router:多个独立初始化的 sigmoid 路由器一起打分。一个专家只要被某一个路由器强烈看好,或者被几个同时看好,就有机会入选;某个路由器打错分,也压不住其他路由器的判断。路由器之间的偏好会明显分化,而激活专家数、FLOPs、通信量和单路由器完全一样——不额外花钱,只换了个选人机制。
每个 MoE 层 512 个路由专家选 10 个,外加 1 个共享专家,负载均衡靠 bias 修正,不用辅助损失。专家还都住进了 2048 维的隐空间:token 先从 4096 维投影下来,专家在里面算完,再经一次共享上投影回去。相对全宽专家,dispatch/combine 的通信量和专家 FLOPs 大约减半。
把 MTP 模块删了
多 token 预测(MTP)是老办法:在主干上额外挂一个专用模块去预测未来 token。多步损失主要监督那个挂件,主干各层还是只为下一个 token 服务。
ERNIE 5.5 Flash 用 ECHO 把它换掉了——直接拿主干自己的最后一层来预测未来。不新增 MTP Transformer 层,多步损失直接压在生成下一个 token 的那批参数上。逼着这些参数去预测更远的 token,等于逼主干提前规划后面几步,推理和代码任务上收益明显。
这层还顺带成了投机解码的草稿模型。官方在 GSM8K、batch size 1、贪心解码下测:1/2/3 步起草的平均接受长度是 1.93 / 2.28 / 2.36 个 token,2 步就拿走大部分收益。SGLang 的低延迟部署方案里,默认就开着 2 步 ECHO。
另外两处小改动也值得记一笔。残差流换成了 mHC(流形约束超连接),每层通过受约束的混合矩阵读写 4 条并行残差;输出头用 MultiMax,可学习的分段温度,既压掉不合理 token 的长尾,又保留合理候选的多样性。分词器是全新的 200K BPE,数字按从右到左、最多三位一组切——1,234,567 会切成 1 234 567,让不同位数的数字对齐,做算术时更友好。
省下来的,变成了分数
架构省下来的算力和显存,最后都体现在了榜单上。同一套评测框架、同样的 prompt 和 few-shot,跟 DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base(295B-A21B)、MiMo-V2.5-Base(310B-A15B)放一起比:
- MMLU 93.3,另外三家是 89.4 / 87.5 / 87.6
- MMLU-Pro 78.4,第二名 69.2
- HumanEval+ 82.3,第二名 78.0;LiveCodeBench 40.1,第二名 33.5
- RepoQA 91.7,第二名 91.3;LongBench-v2 48.7,第二名 44.5
- GPQA 60.2,第二名 55.9
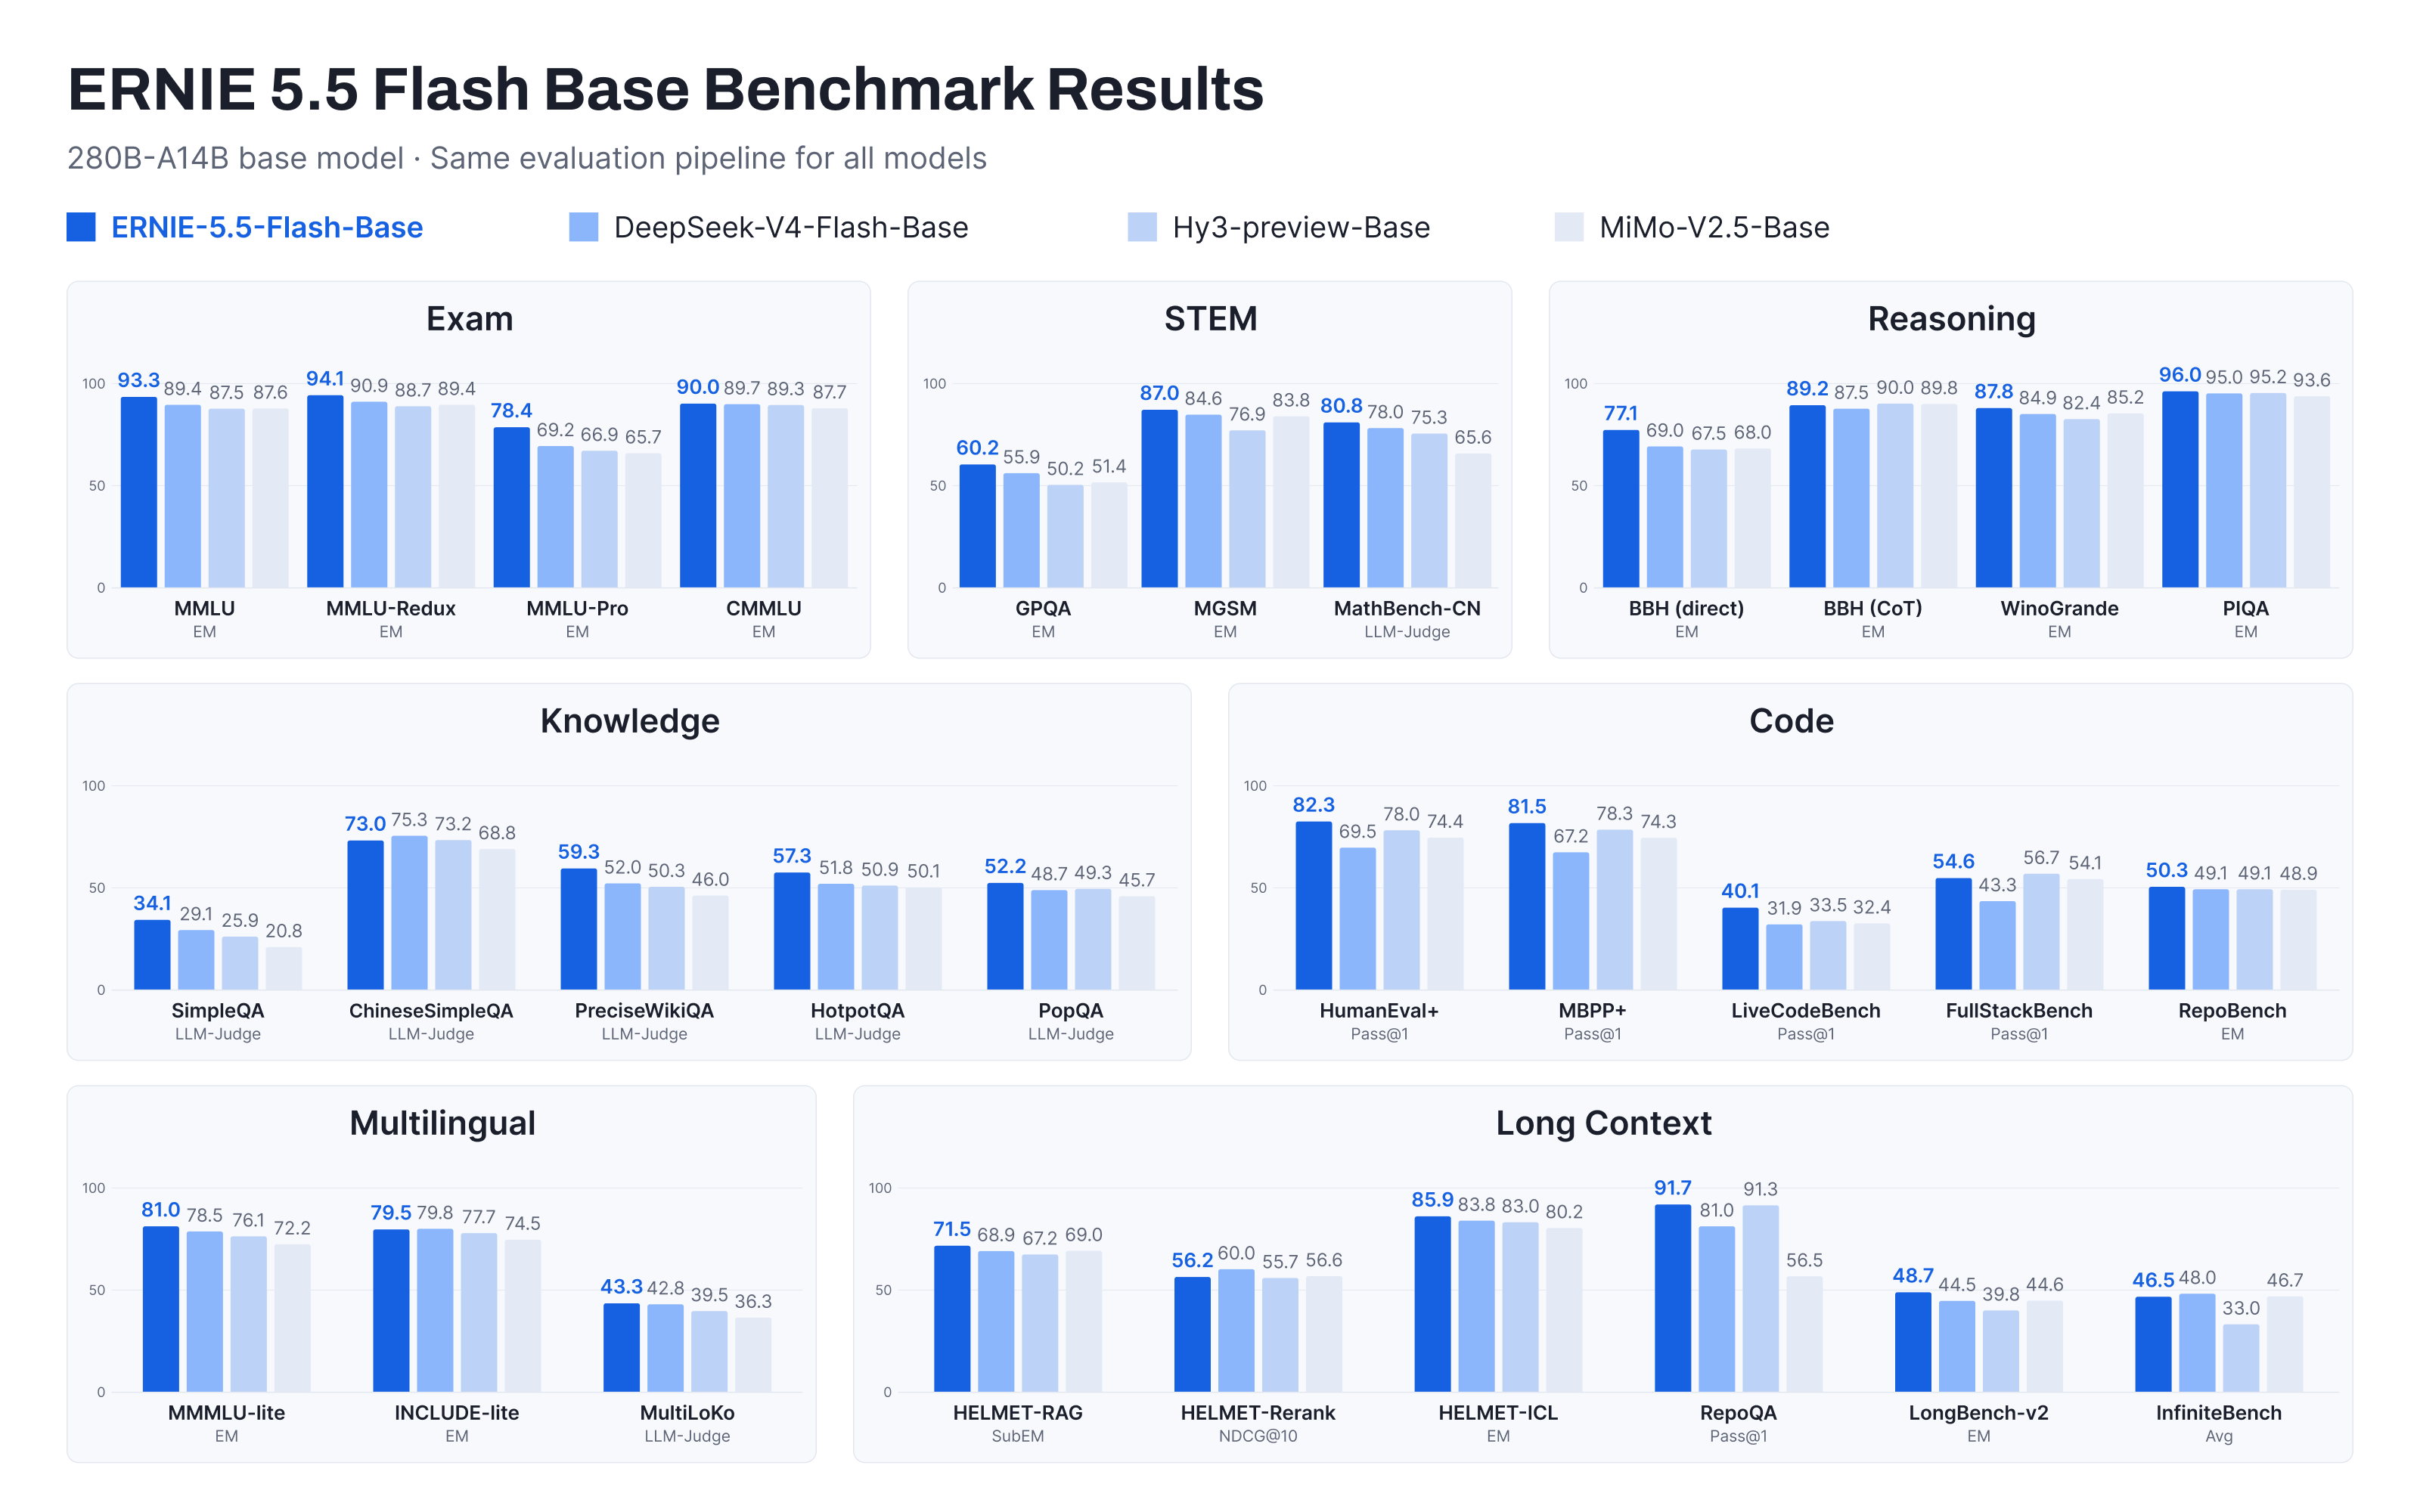
也不是全赢。ChineseSimpleQA 73.0,输给 DeepSeek 的 75.3;HELMET-Rerank 56.2,输给 60.0;InfiniteBench 46.5,输给 48.0;FullStackBench 54.6,输给 Hy3 的 56.7。考试、代码、仓库级理解是它的强项,超长文档的细粒度检索和重排不是。
授权文件不是 Apache 2.0
这一点得说清楚,因为已经有人写错了。
SGLang 的 cookbook 里写着这个模型 "released under the Apache-2.0 license"。但 Hugging Face 仓库里那份 LICENSE 打开是另一回事:ERNIE 5.5 Flash Base Model License Agreement v1.0,自定义协议。Apache-2.0 是 vLLM-ERNIE 那个插件代码仓库的协议,不是权重的。
真正的条款是这样:
- 非商业用途(学术、教育、评估、个人实验)免费,不用报备
- 商业用途,如果相关产品年营收 不超过 5000 万美元,免授权费,但要满足两条:界面或文档显眼位置标注 "Powered by ERNIE",并且在首次商用前发一封一次性告知邮件到 Baidu_ERNIE@baidu.com
- 超过 5000 万美元,必须提前拿到书面商业授权,费用另谈;收入涨过线要先联系,授权生效前相关商用得暂停
- 营收按同一控制下的所有实体合并计算,连续 12 个月滚动评估,不能拆公司绕线;超过门槛的还要每年配合一次合规核验
对比一下同行的门槛:Llama 系看月活(7 亿),Kimi K3.1 Pro 看 MaaS 收入(2000 万美元),这里是看你的产品收入(5000 万美元)。对绝大多数创业公司和内部项目,这条线基本碰不到——但"发邮件报备 + 界面标 Powered by ERNIE"是硬要求,别漏。
想自己跑,先数卡
FP8 权重约 280GB,BF16 约 560GB。SGLang 给的官方配方:
| 显卡 | FP8 | BF16 |
|---|---|---|
| B300 / GB300(288GB) | 2 张 | 4 张 |
| B200(192GB) | 4 张 | 8 张 |
| GB200(192GB) | 4 张 | 2 柜 × 4 张 |
| H100(80GB) | 8 张 | 2 节点 × 8 张 |
单机 FP8 的配方在 B300、GB300、B200、GB200、H100 上都验证过;BF16 只验证了 B300,其余是按显存预算推的。想开 100 万上下文,还要把 --max-running-requests 压到个位数——每个 rank 的 KV 池得装下完整的百万 token 请求,一次百万 prefill 还要几十 GB 的临时激活。
vLLM 那边靠 baidu/vLLM-ERNIE 插件,跑在官方 0.32.0 轮子上,一行没改,但只支持 NVIDIA。仓库 10 月 27 日才建,36 个 star——很新,用之前先看 issue。
还有一点容易踩:这是 Base 模型,不是聊天模型。没有 chat 模板、没有推理链、没有工具调用,只能走 /v1/completions 续写,输入还要求以 BOS 开头(add_special_tokens=True)。想拿它当 ChatGPT 用,得自己做后训练。
它给的是一个起点,不是一个产品
百度说得很直白:这是预训练终点的 checkpoint,没经过任何中训练和后训练。它的价值不在"开箱即用",在于你可以拿 33.5T tokens 训出来的底子,去做自己的领域适配、指令微调、强化学习——不用从零烧一遍预训练。
后训练版的 ERNIE-5.5-Flash 说是在路上了,带 FP8 / FP4 / BF16 三个版本,还捆了 DSpark 草稿模型,支持推理和工具调用。
所以现在的选择很清楚:想直接调用,等后训练版;想自己做模型,这 280B 的 Base 是当下少有的、条款写得明明白白、14B 激活就能跑起来的起点。前提是你有卡,也有后训练的人。
相关链接:
- Hugging Face 权重(FP8):https://huggingface.co/baidu/ERNIE-5.5-Flash-Base
- Hugging Face 权重(BF16):https://huggingface.co/baidu/ERNIE-5.5-Flash-Base-BF16
- 官方技术博客:https://ernie.baidu.com/zh/release/ernie-5-5-flash-base
- SGLang 部署手册:https://docs.sglang.io/cookbook/autoregressive/Baidu/ERNIE-5.5-Flash
- vLLM 插件:https://github.com/baidu/vLLM-ERNIE
暂无评论。