会做梦的 AI 记性更好
11 月 6 日,Anthropic 发了一篇工程博客,讲 Claude 怎么记住东西。
里面有个词很扎眼:dreaming,做梦。
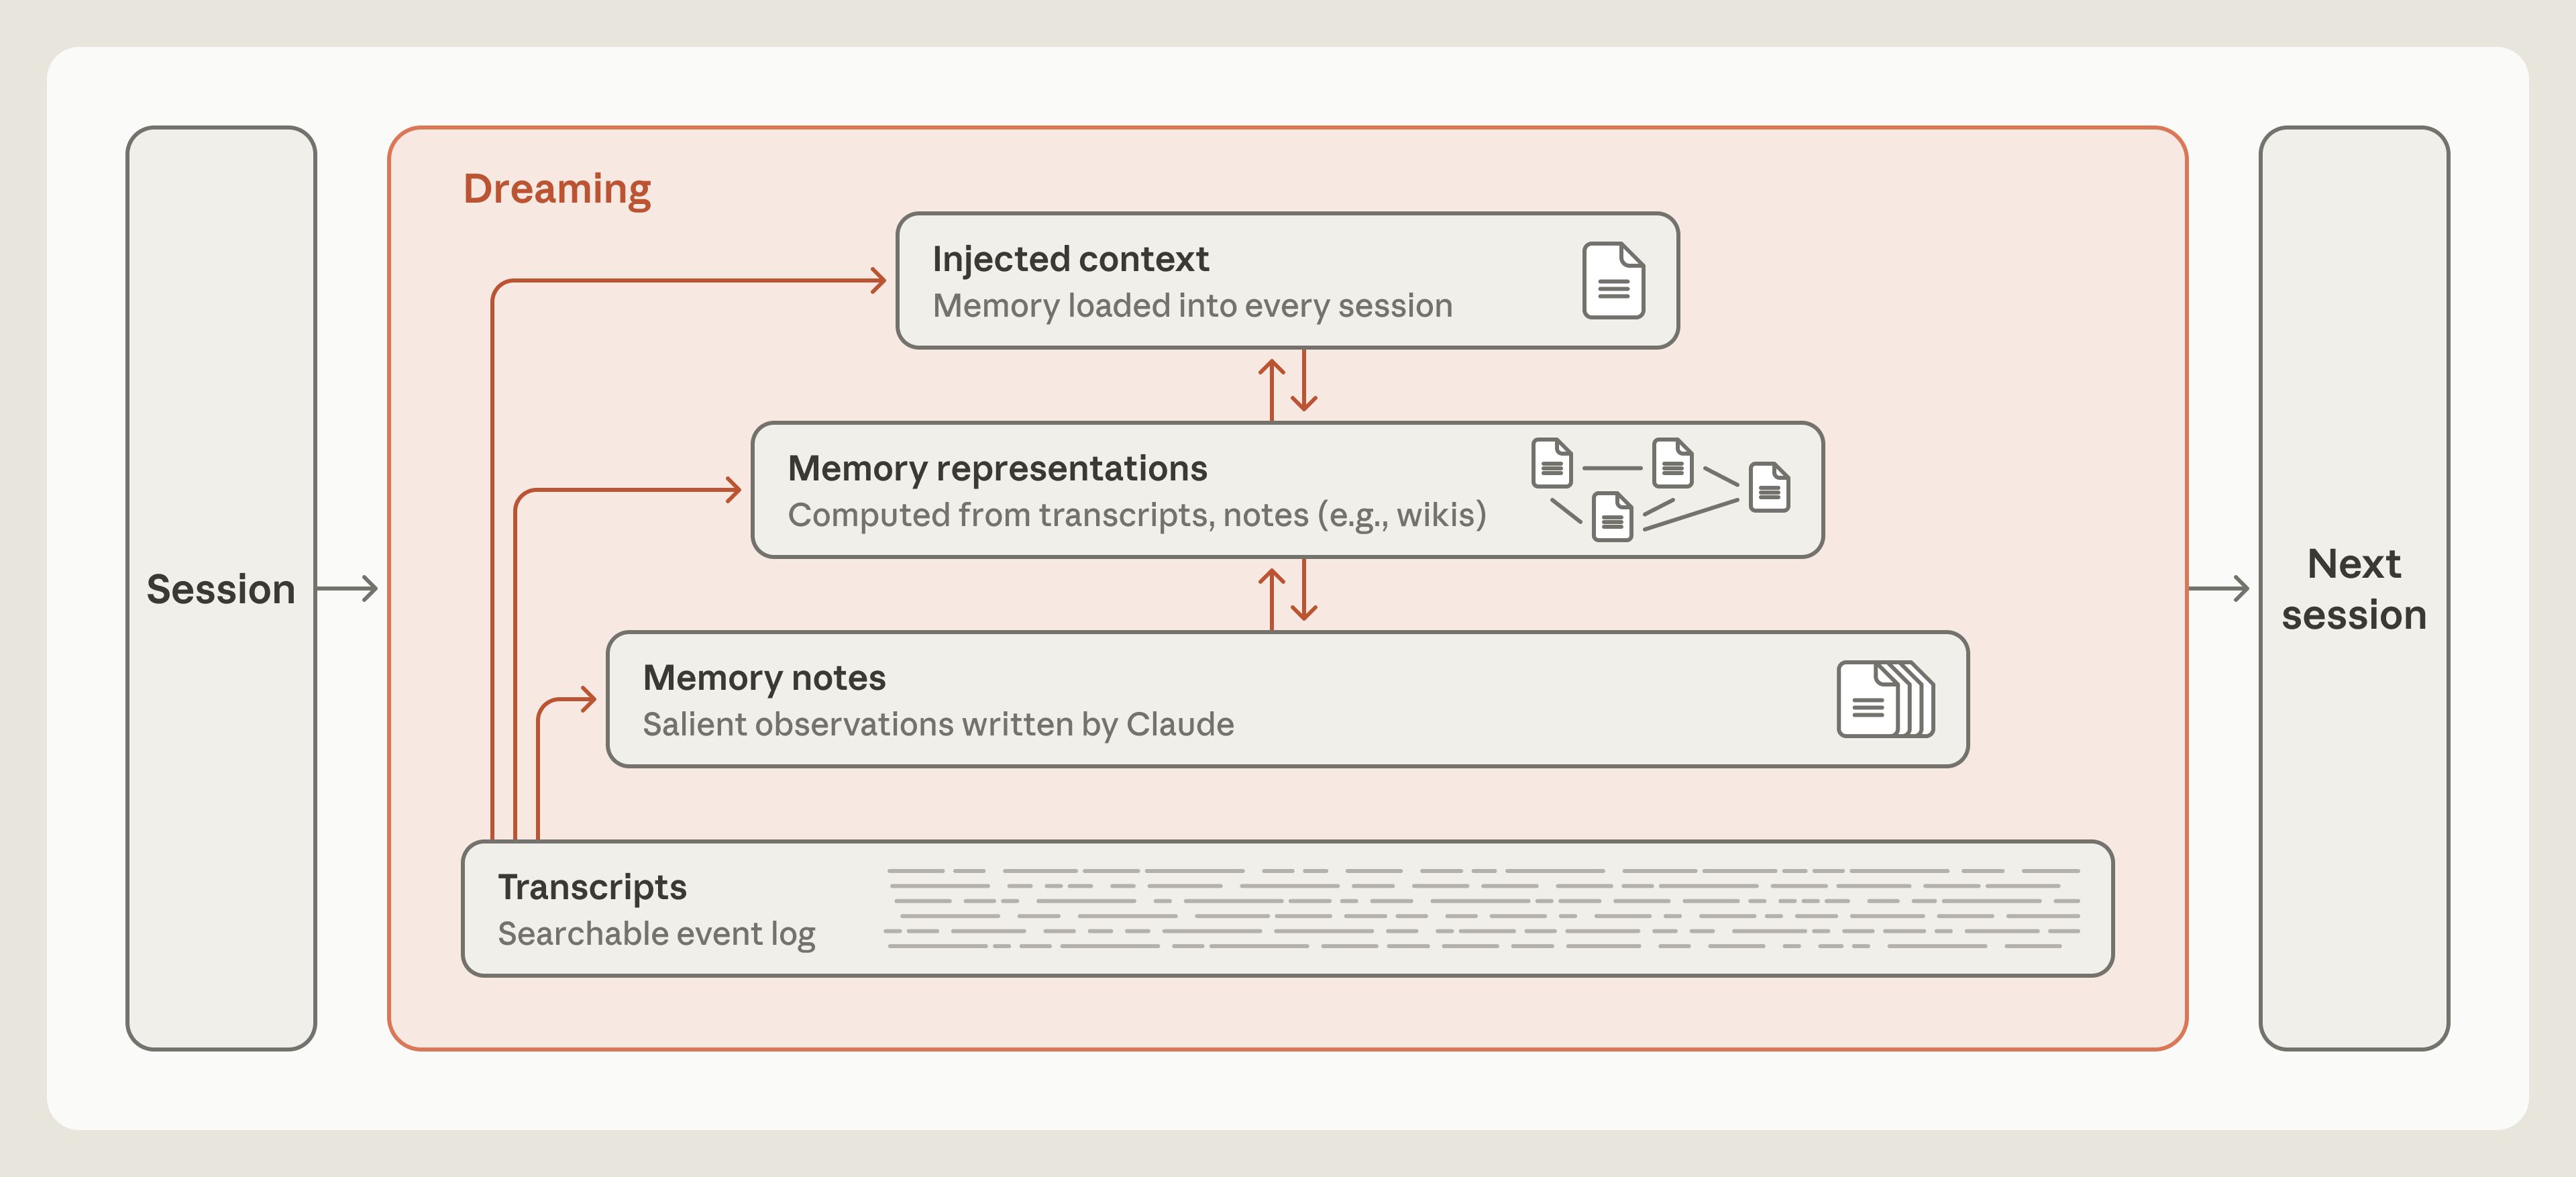
不是比喻式的营销词,是产品里的一个机制。两次对话之间的空闲时间,Claude 会回放自己的会话日志,改掉记错的笔记,合并重复条目,建 wiki,再决定下次开局要预加载哪些内容。
灵感来自人脑。睡眠时海马体会重放白天的经历,慢慢整合进新皮层。Anthropic 借用了这个分工:醒着的时候记录,睡着的时候整理。
记忆分四层
官方给的图很清晰,从下往上:
- 会话日志:一次对话里的全部事件,可搜索
- 记忆笔记:Claude 自己写的观察,比如“这个项目用 pnpm,不用 npm”
- 记忆表征:把笔记连成结构,比如一个 wiki
- 注入上下文:下次开会话时,预加载进去的那一小部分
大部分 agent 只做第一层——存日志,下次把相关片段塞回去。Claude 这套的重点在上面三层:写笔记、建结构、决定加载什么。
而 dreaming 的箭头,是从日志指向上面的每一层。它在离线时做整理,不占用你对话的时间。
记忆到底值多少
Anthropic 在 CL-Bench 的数据库任务上测了带记忆和不带记忆的差距:
| 模型 | 无记忆 | 有记忆 |
|---|---|---|
| Opus 5.5 | 0.655 | 0.838 |
| Sonnet 5.5 | 0.644 | 0.833 |
| Opus 5 | 0.564 | 0.828 |
| Opus 4.7 | 0.383 | 0.700 |
| Sonnet 5 | 0.306 | 0.610 |
| Sonnet 4.6 | 0.330 | 0.364 |
Opus 5.5 从 0.655 提到 0.838,涨幅 28%。越老的模型,记忆带来的相对提升越大——Sonnet 4.6 直接翻倍还多。这其实说明一件事:记忆能在一定程度上补模型能力的差距。
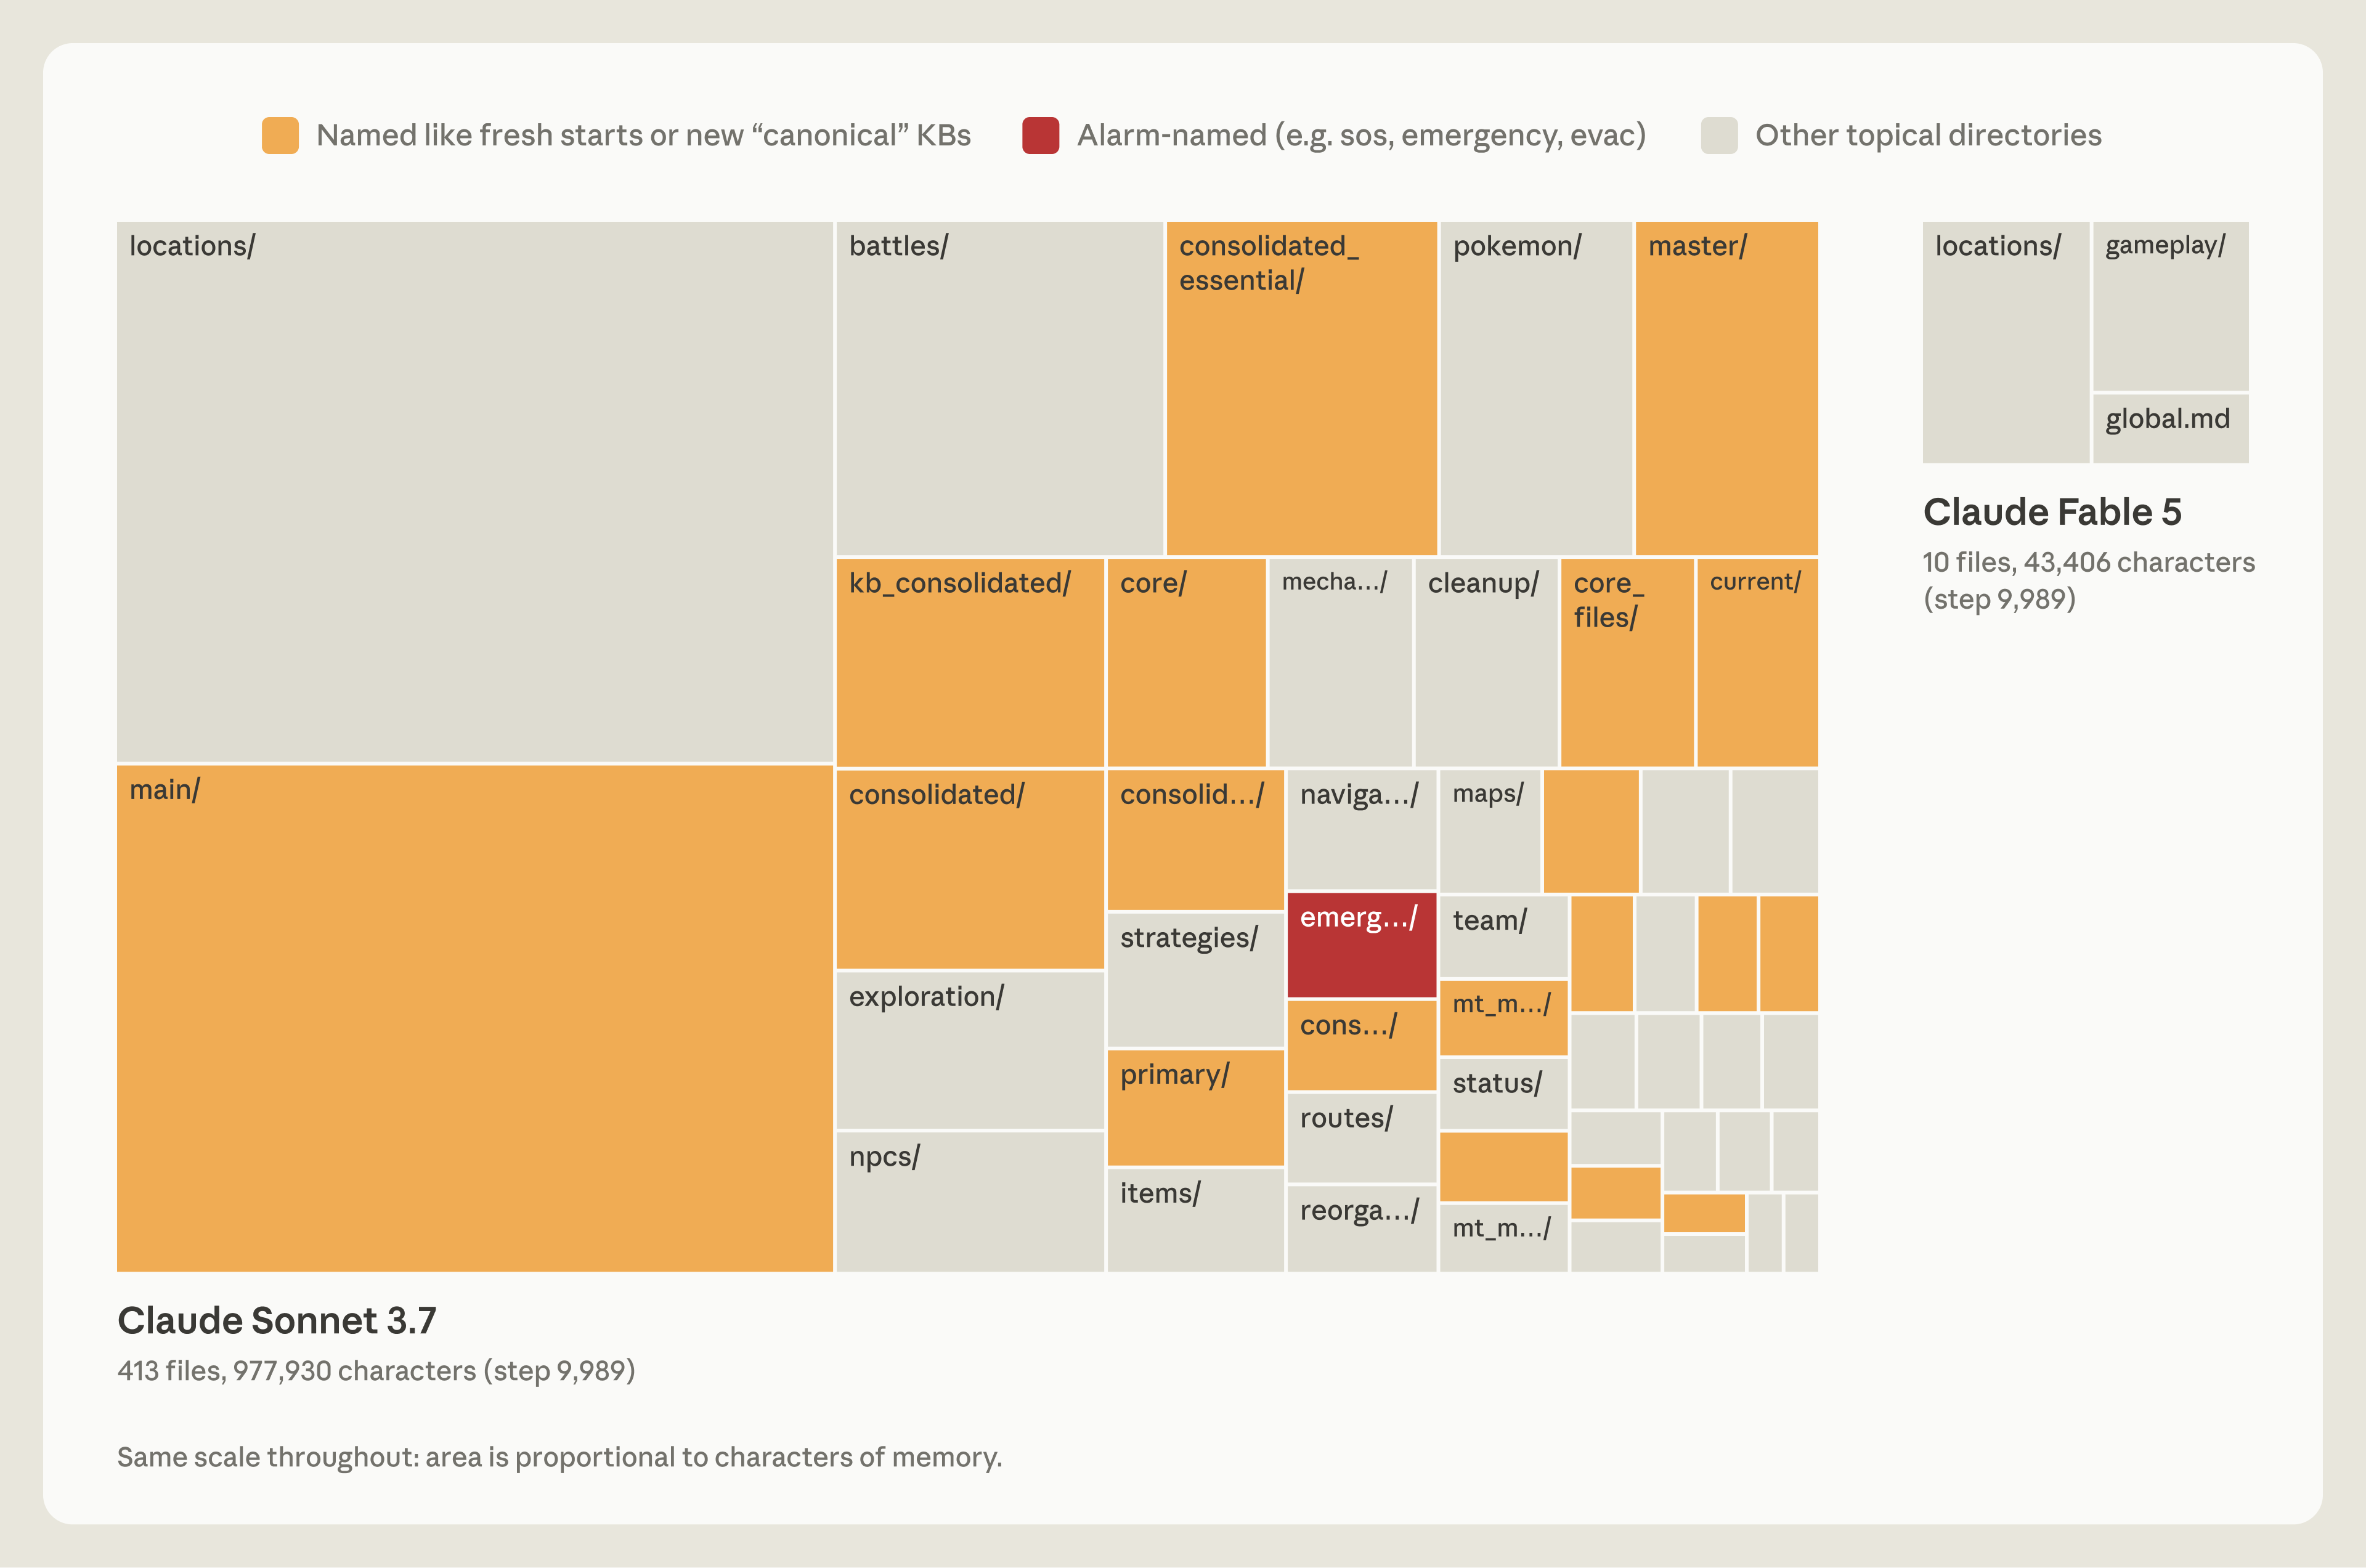
更直观的是《宝可梦红》。
Anthropic 让不同模型玩同一个游戏,各自维护一个记忆文件夹。Sonnet 3.7 写了 413 个文件、225 个文件夹、977,930 个字符,最后只拿到 1 个徽章。Fable 5 只写了 10 个文件、43,406 个字符,拿到 4 个徽章。
同一个游戏,记忆体积差了 22 倍,成绩反过来。
写得少,反而记得住
这篇博客里最值钱的是几条反直觉的结论。
第一,别告诉它“怎么记”,告诉它“记来干嘛”。
Anthropic 的原话是:告诉 Claude 记忆的用途,但不要规定它怎么用。他们试过让模型“只记录失败”,结果 Opus 5 的成绩掉了 0.234,Opus 4.7 掉了 0.150,Sonnet 4.6 掉了 0.020。你越指挥它怎么写笔记,它写得越差。
第二,共享一张表,会互相覆盖。
四个 agent 同时往 provisions.md 里写合同条款,一个保存,另一个的行就没了。57 条受评分的事实,最后只剩 41 条,28% 丢失。改成每个 agent 写自己那份合同、条款逐字复制之后,57 条全活。
多 agent 协作的记忆设计,第一条不是“共享”,是“分区”。
第三,wiki 要够大才划算。
在 2M 到 128M dreaming token 的区间里,wiki + 搜索从 54% 提到 61%,单靠 wiki 从 13% 提到 48%,而只用搜索一直是 53%。也就是说,wiki 小的时候不如搜索,大到一定程度才超过。建知识库不是越多越好,是过了规模拐点才有复利。
第四,做梦真的能改错。
宝可梦的一个案例:raw memory 里存了一条错笔记,agent 照着走,往下一个城市去了。dreaming 回放日志时发现这条笔记和实际经历对不上,改了过来;再跑,agent 回到洞口,最后在第 1,935 个动作到达 Cerulean。没有记忆的那组,从来没到过。
但也别把“做梦”神化
Anthropic 自己说得很克制:dreaming 目前还是研究预览,5 月才进 Managed Agents API,不是所有场景都验证过。
社区的担心也很实在:离线反思如果改错了,错误会被写进长期记忆,而且比一次对话里的错误更难发现。你看到的是它“记得”,看不到它“记错了”。
另一派开发者更直接:他们宁愿用纯 markdown 的记忆文件,因为能读、能 diff、能回滚。自动整理的黑箱,出了事不好查。
这两种做法不矛盾。dreaming 解决的是规模问题——日志太多,人读不过来;但在关键项目上,保留一份人能看懂、能手动改的记忆,仍然是必要的。
最后
我们总把 AI 的记忆当成存储问题:上下文多大、能记多少 token、要不要上向量库。
Anthropic 这篇讲的是另一件事:记忆是整理问题。
记得多不等于记得住。413 个文件的 Sonnet 3.7 输给了 10 个文件的 Fable 5;共享一张表的四个 agent 丢了 28% 的事实;写满笔记的模型,反而不如会删笔记的模型。
人也是这样。睡一觉不是为了多记,是为了把该记的留下。
相关链接:
- Anthropic 原文:https://www.anthropic.com/research/components-of-agent-memory
- Managed Agents 的 dreaming 文档:https://platform.claude.com/docs/en/managed-agents/dreams
- sleep-time compute 论文:https://arxiv.org/abs/2504.13171
暂无评论。