Qwen4 还没发布,先在游戏榜上把 Opus 5.5 超了
11 月 9 日,一个叫 GameFeel Bench 的榜单更新了一行数据:
Qwen4-Flash-Early,49.9 分。
排在它后面的是 Claude Opus 5.5(XHigh),47.2 分。
一个还没发布的模型,用一个“轻量版”的早期预览,在一个游戏开发榜上,超了 Anthropic 现在的旗舰。完成同样一个任务,它花 $0.40,Opus 5.5 花 $2.60。
同一天上榜的还有 Qwen4-27B-Early:44.6 分,接近 Sonnet 5.5 的 45 分,单任务成本 $0.16。
这不是 AA,也不是 Arena。它是一个独立游戏开发者做的垂直榜,样本只有 12 个游戏。但在 Qwen4 正式发布之前,这是第一个能拿来看的硬数字。
这个榜,测的不是考试
GameFeel Bench 的作者是一个独立游戏开发者,评测方式很具体:
- 给模型 12 个未公开的游戏项目
- 每个模型要给游戏加内容、做平衡性修改
- 从 7 个维度打分:实现、bug 发现、平衡、创意、视觉、音效、RE
- 当前版本 v1.4
它考的不是“这道题会不会做”,而是“给你一个半成品游戏,你能不能把它改得更好玩”。
这恰好是现在 Agent 最值钱的能力:不是单轮生成,是在一个已经有状态的项目里,持续做对的修改。
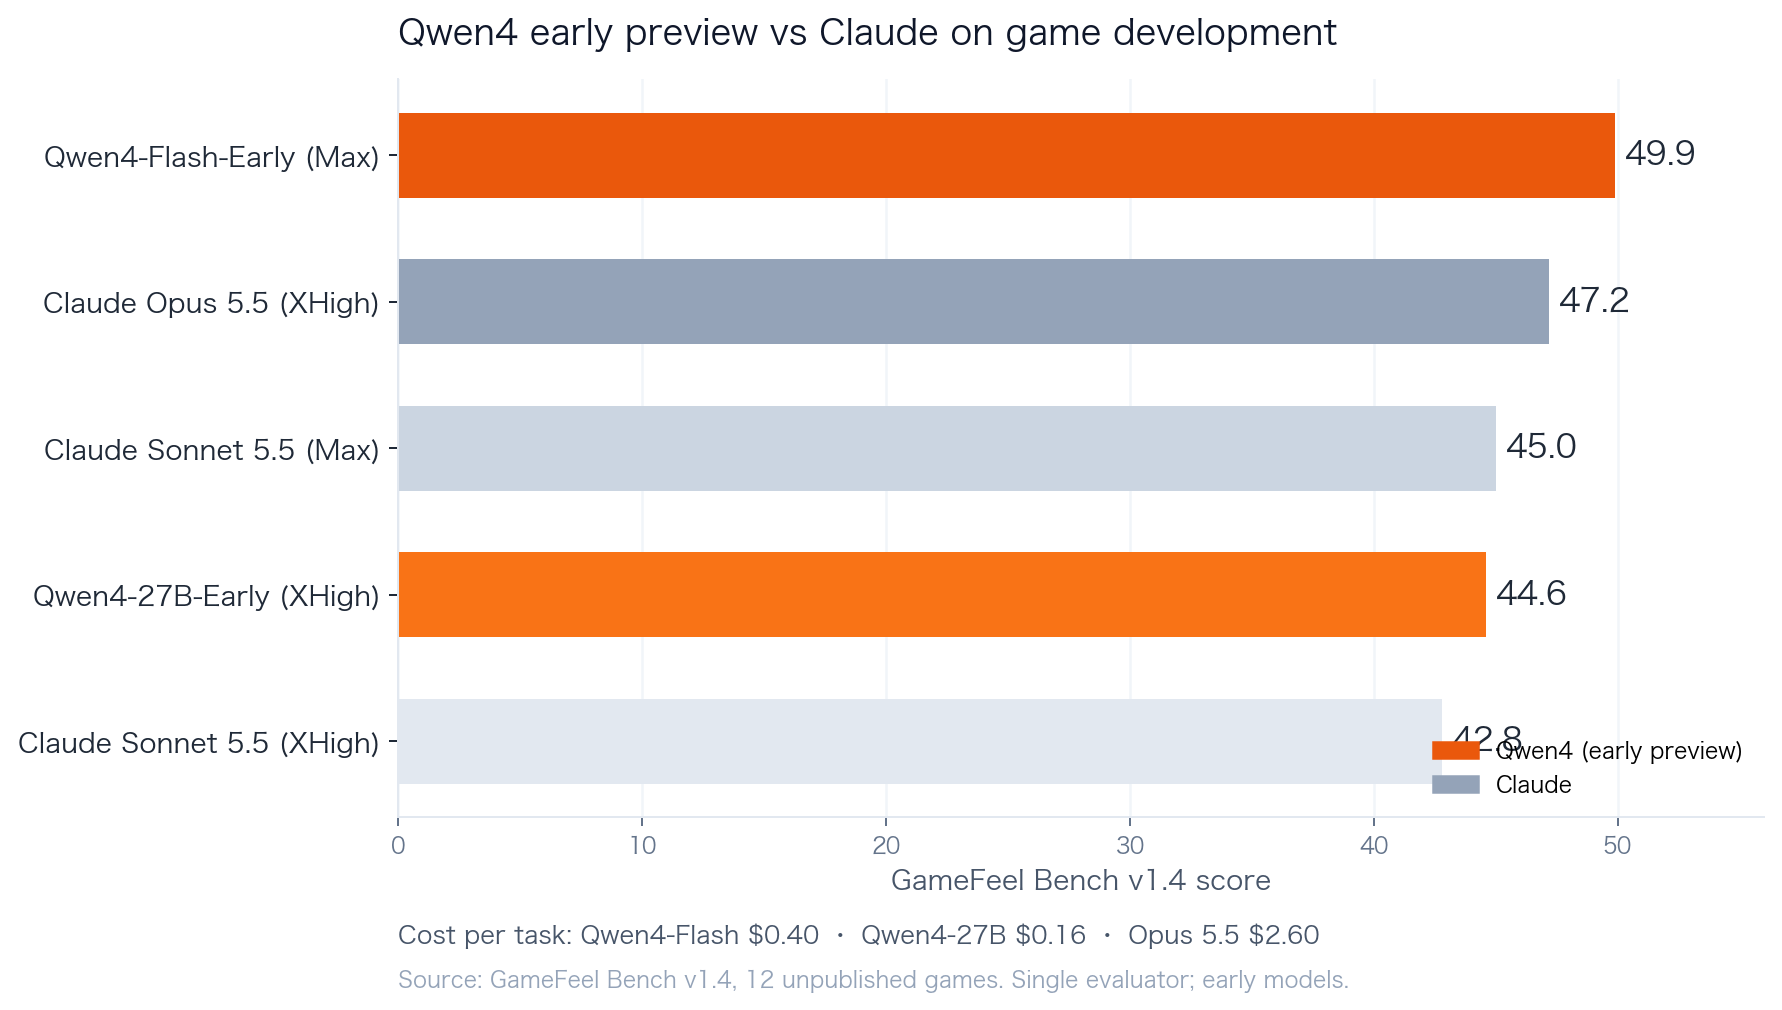
五个成绩放一起:
- Qwen4-Flash-Early(Max):49.9,$0.40/任务
- Claude Opus 5.5(XHigh):47.2,$2.60/任务
- Claude Sonnet 5.5(Max):45.0
- Qwen4-27B-Early(XHigh):44.6,$0.16/任务
- Claude Sonnet 5.5(XHigh):42.8
Flash 的成本是 Opus 的约六分之一,27B 是约十六分之一。
如果这个数字能在正式版上站住,Agent 的定价逻辑会被改一遍。
先别急着开香槟
这条数据有几个必须说清楚的前提。
第一,它是早期预览版。 模型名里带 Early,不是最终发布的 Qwen4。早期版可能更强,也可能因为安全对齐、稳定性调整而变弱。
第二,27B 的分数刚被修正过。 最初写的是 47.0,后来作者发现音效评分算错,改成了 44.6。这说明评测流程还在迭代,数字不是一次成型。
第三,49.9 不是 27B 的成绩。 Flash 和 27B 是两个模型,不能把 Flash 的第一名当成“本地 27B 也第一”。
第四,样本很小。 一个人、12 个游戏、一个垂直榜。2.7 分的领先,换一次重跑就可能变。它证明的是“这个方向有戏”,不是“全面超过 Opus 5.5”。
第五,GameFeel 测的是游戏开发创造力,不是通用推理、代码库维护、长程 Agent。 这些能力要看 Terminal-Bench、SWE-bench、AA 这类榜。
所以更准确的说法是:Qwen4 的早期 Flash,在“改游戏”这件事上,单点超过了 Opus 5.5;Qwen4-27B 摸到了 Sonnet 5.5 的边。
官方只说了三个字:在训练
把时间线拉出来,会发现这事不是突然发生的。
| 时间 | 发生了什么 |
|---|---|
| 8 月下旬 | Qwen3.8-Flash-Next 开源,官方称是“Qwen4 架构的实验性预览” |
| 9 月 22 日 | 阿里云栖大会新闻稿:Qwen4 “currently in training” |
| 10 月 28 日 | qwen-code 的 PR 把 qwen4 系列按 1M 上下文配置 |
| 10 月 29 日 | 阿姆斯特丹云栖,CTO 被引述“Qwen4 next week”;幻灯片列出四个型号 |
| 11 月 6 日 | Qwen 官方发“The becoming begins”,配图“北冥有鱼,其名为_” |
| 11 月 7 日 | Qoder 出现匿名模型 QoDuck,社区怀疑是 Qwen4 |
| 11 月 9 日 | GameFeel Bench 出现 Qwen4-Flash-Early 和 27B-Early 的成绩 |
官方确认的只有一件事:Qwen4 在训练。
没有模型卡,没有权重,没有 API 模型 ID,没有价格,没有许可证,没有发布日期。
“下周发布”是参会者转述 CTO 的话,11 月 2—8 日这个窗口已经过去,没有发布。现在传的“11 月 10 日 23 点(PT)发 27B”来自 Reddit,不是官方。11 月 11 日东京有一场 Qwen meetup,也被当成可能的节点。
真正该盯的三个地方:Qwen 的 Hugging Face 组织页、@Alibaba_Qwen 的 X 账号、qwen.ai 的博客。这三个地方出现模型卡或权重,才算发布。
四款型号,目前只有名字
阿姆斯特丹的幻灯片列了四款:
| 型号 | 定位 | 状态 |
|---|---|---|
| Qwen4-Max | 旗舰,复杂推理、Agent,API 为主 | 只有名字 |
| Qwen4-Plus | 中间档,多模态、通用 API | 只有名字 |
| Qwen4-Flash | 快、便宜、高并发 | 有早期跑分 |
| Qwen4-27B | 本地部署,单卡、大内存 Mac | 有早期跑分,传开源 |
四款的参数、上下文、价格、许可证,官方一个都没公布。
Qwen 的代码里还出现过 qwen4-coder-plus、qwen4-omni-120b 之类的 ID,说明家族可能不止四款,但这些同样没有官方确认。
架构线索:看 Qwen3.8-Flash-Next
Qwen4 的架构预览版是 Qwen3.8-Flash-Next,规格比较明确:
- 总参数 125B,每 token 激活 6B
- 512 个专家,10 个 routed + 1 个 shared
- 额外 51B n-gram embedding 表 + 4B MTP 头,落盘约 180B
- 原生上下文 262,144 token,YaRN 可扩到 1M
- 输入支持文本、图像、视频,输出文本
- 许可证是
qwen-community-1.0,不是 Apache 2.0
Qwen4 大概率沿用这套稀疏 MoE + 原生多模态的设计。但 Max 的具体规模、27B 是 dense 还是 MoE,官方都没说。
27B 才是本地玩家该盯的
对大多数开发者来说,Max 和 Plus 是 API 的事,真正改变工作方式的是 27B。
上一代 Qwen3.8-27B 是 Apache 2.0 开源,4-bit MLX 版本约 16GB,能在单卡或大内存 Mac 上跑。如果 Qwen4-27B 延续这个路线,并且 44.6 分接近 Sonnet 5.5,那它会是本地部署的一个新基准。
早期权重据传约 35GB,这是 BF16 口径;量化之后能压到多少,要等社区实测。
对本地玩家来说,关键不是“它是不是第一”,而是“它能不能在我的 24GB/32GB 显存上,稳定干完一个长任务”。
QoDuck 是不是它
QoDuck 是 11 月 7 日出现在 Qoder 里的匿名模型:每天免费额度、1M 上下文、最高思考档不扣 Credits。
社区普遍怀疑它就是 Qwen4 的预览版,理由很直接:
- 时间点紧接 11 月 6 日的预热
- 计费系数 0.5×,和 Qwen 旗舰档位对得上
- 支持 1M 上下文
- 有测试者称模型体积约 27GB(未证实)
但阿里没有确认。更稳妥的说法是:QoDuck 是 Qwen4 发布前的一次真实场景灰度,可能是 Qwen4,也可能是同架构的另一个版本。
什么时候能真正用上
短期看三个信号:
- Hugging Face 出现 Qwen4-27B 的模型卡——这是本地玩家真正能动手的时刻
- 阿里云百炼/OpenRouter 出现 qwen4 的 API ID 和价格——这是开发者能接的时刻
- Qwen4-Max 的模型卡——这是判断它能不能全面对标 Opus 5.5 的时刻
Manifold 的预测市场给“12 月前发布”93.5%,给“11 月 25 日前开源权重”83%。市场很乐观,但市场也会错。
最后
这次最值得注意的,不是“国产模型第一”这个标题,而是两个数字的对比:
49.9 分,$0.40。47.2 分,$2.60。
如果 Qwen4 正式版能把这个性价比保持住,哪怕它只在部分任务上接近 Opus 5.5,Agent 的成本结构也会变。不是“谁更强”的问题,是“同样的活,谁更值得被大量调用”。
但在此之前,它仍然是一个没发布的模型,和一个只有 12 个游戏的榜单。
单点超车不难,难的是全面可用。
参考来源:
暂无评论。