免费调用 321B 模型,它在一个问题上转了 1,670 圈
0 积分,321B 参数,262K 上下文,OSWorld 83 分。
MOSS API 把 Nex-N2.6 限时免费开放了:只要有有效的 API Key,调用就不扣积分。官方文档写得很干脆——“限时免费,0 积分”,也没写结束日期。
听起来像白捡一个前沿智能体模型。
但第三方测试里,这个模型在一道数据分析题上跑了 1,670 次调用、2 小时 20 分,最后还没找到答案。另一道题跑了 650 次调用、70 分钟,直到对话撑爆 262K 上下文才停下。
免费的是 API,不是时间。
0 积分是真的,但“免费”只免了账单
先把能确认的规则说清楚。
MOSS API 的文档写明:Nex-N2.6 限时免费,所有有效 Key 都能调用,每次请求消耗 0 积分;响应里的 usage 字段照常返回 Token 用量。
日常调用用模型别名 nex-n2.6,需要固定版本就用 nex-n2.6-2026-11-05。接口地址是 https://api.mosi.cn/v1,兼容三种协议:
- OpenAI Chat Completions
- OpenAI Responses
- Anthropic Messages(用
x-api-key+anthropic-version)
输入支持文本、图片、视频;输出只有文本。Chat Completions 和 Responses 支持 video_url,Messages 不支持视频。单次请求体(含媒体编码)不超过 10 MiB;输出默认 8192 Token,最高可以设到 131072。
免费不等于无限制:Token 照记、GPU 照跑、排队照排,只是不扣你的积分。官方也没承诺 SLA,没写什么时候结束。
这更像一次限时拉新,而不是长期定价。
它不是新模型,是给 GLM-5.3-Flash 加了一层后训练
Nex-N2.6 来自上海的 Nex-AGI。它不是在空白底座上从头训练的,而是拿 Z.ai 的 GLM-5.3-Flash 做后训练,成品的参数量约 321B,FP8 权重,Apache 2.0 许可,上下文 262K。
它的定位很明确:操作电脑界面、写代码、连续调用工具的长任务。
这代还换了一次底座。上一代 Nex-N2.5 Pro 用的是 Qwen3.5 的 397B MoE,N2.6 换成了 GLM-5.3-Flash。换底座不只是换个名字——tokenizer、工具调用解析、chat template、失败模式都会跟着变。你在 N2.5 Pro 上调好的长系统提示词,不能假设在 N2.6 上原样成立。
官方给的跑分是这样:
| 指标 | GLM-5.3-Flash | Nex-N2.5-Pro | Nex-N2.6 |
|---|---|---|---|
| OSWorld | 78.0 | 82.2 | 83.0 |
| Terminal-Bench 2.1 | 84.3 | 82.7 | 84.1 |
| AutomationBench | 48.8 | 44.2 | 45.7 |
OSWorld 83.0,比底座高 5 分,比上一代高 0.8 分。Terminal-Bench 84.1,基本贴着底座,没超。AutomationBench 45.7,比底座低 3.1 分。
这组数字说明一件事:后训练确实把“操作电脑”这一项拉上去了,但没有把底座的所有能力都抬高。 它在某些维度更强,在另一些维度还不如底座。
而且这是厂商自测。Nex-AGI 自己也在模型卡里写了:“分数取决于评测框架和设置。”
官方说它不重复想,第三方看到它重复做
Nex-AGI 这次最核心的卖点是“减少重复推理”。
官方数据:相比 N2.5 Pro,推理重复率从 **16.0% 降到 1.6%**,相对下降 90%;整体非重复率 97.8%;在 956 个上下文的内部评测里,工具选择有效率达到 **100%**。
这些数字如果成立,对长任务 Agent 很值钱——少绕圈,就少烧 Token。
但第三方测试给出了另一个画面。
Plotly 用 43 道数据分析题跑了一遍:Nex-N2.6 过了 38 道,和底座 GLM-5.3-Flash 同分。常规分析、模糊问题、不可能请求、统计陷阱,它全对;但 5 道“隐藏模式”题,它只找到 1 道,底座找到 4 道。
更关键的是两道题的过程:
- 第一道,它做了约 1,670 次模型调用,持续 2 小时 20 分,反复用略微不同的过滤条件切同一张表;
- 第二道,约 650 次调用,70 分钟,直到对话超过 262K 上下文、服务端报错才停。
两次都是上下文爆了才停,不是它自己想停。重试后 5 分钟内结束,但答案还是没找到。
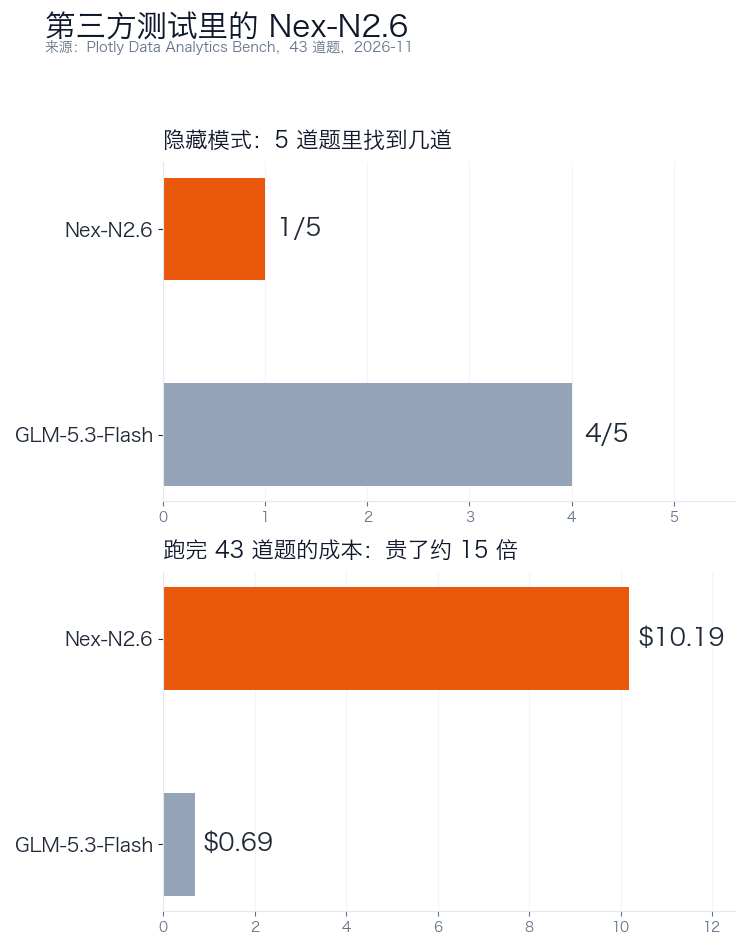
成本也很有意思:这一轮 43 题,Nex-N2.6 花了 $10.19,底座 GLM-5.3-Flash 只花 $0.69,差了约 15 倍。中位答题时间 68 秒,比底座的 87 秒快,但慢于榜上 46 个模型里的 36 个。
所以“重复率下降 90%”和“1,670 次调用”并不矛盾——它们说的不是同一种重复。
官方测的是推理文本里的重复:同一句话、同一个思路反复出现。第三方看到的是行动上的重复:话可能每次都不一样,但做的还是同一件事——换一个过滤条件,再查一遍。
这恰恰是 Agent 最危险的一种循环:它看起来在推进,日志里每一步都“有新内容”,但整体没有前进。
免费 API 怎么接,先给它设好刹车
接入本身不复杂,三步:
- 在 MOSS 控制台创建一个 API Key;
- OpenAI SDK 的
base_url填https://api.mosi.cn/v1; model填nex-n2.6,需要固定版本就用nex-n2.6-2026-11-05。
要用 Anthropic Messages,把鉴权换成 x-api-key 和 anthropic-version: 2023-06-01;要用固定版本,把模型名换成 nex-n2.6-2026-11-05。
但如果你要拿它跑长任务,代码之外还得加三样东西:
- 步数上限:比如最多 30 次工具调用,到了就停,不管它说没说完;
- 预算上限:按 Token 或金额设阈值,别让一次任务跑到天亮;
- 超时和重复检测:同一工具、同一参数连续出现三次,就中断。
第三方的 1,670 次调用不是模型“坏”,是它没有停止条件。你不设,它就不停。
321B 的开源,和你没什么关系
Nex-N2.6 是 Apache 2.0 开源,权重在 Hugging Face 上,321B 参数,FP8,129 个 safetensors 分片。
但“能下载”和“能跑”是两件事。
321B 的 FP8 权重约 321GB;即便压到 4-bit,按第三方估算仍要 202.6GB。一张 4090 的 24GB 显存,连零头都不够;16GB 的 4060 Ti 更不用想。能比较舒服跑起来的,是 512GB 统一内存的 Mac Studio 这个级别,或者多卡服务器。
所以对绝大多数人,免费 API 不是“省钱方案”,是唯一现实的方案。
这也意味着,你用的不是“自己的模型”,是 Nex-AGI 的单点服务:它限流、它排队、它哪天结束免费,你都没有控制权。
这笔免费账怎么算
免费期结束后,Nex-N2.6 在 OpenRouter 上的价格是 $0.12 / 百万输入 Token,$0.40 / 百万输出 Token,缓存读 $0.024;标价是 $0.15 / $0.50,现在是 20% 的 launch 折扣。
对比上一代 N2.5 Pro 的 $0.075 / $0.25,新模型贵了 60%。底座 GLM-5.3-Flash 本身更便宜。
所以“免费”不是价格战,是一次限时试用:先用 0 积分把你拉进来,等免费结束,再按新价单收费。
第三方的 $10.19 是按标价算的;免费期里这 10 美元不扣,但 1,670 次调用花掉的时间、并发和上下文,不会退给你。
谁该用,谁别把它当生产工具
适合现在试的人:
- 在做 computer use、网页操作、截图理解的 Agent 开发者
- 需要 262K 上下文、工具调用、结构化输出的长任务
- 想拿一个 321B 模型做免费对照实验,看看它和 GLM-5.3-Flash 的差异
- 能自己写步数上限、预算上限、重复检测的团队
别把它直接接进生产的人:
- 需要稳定 SLA 的自动化流程:单点服务,免费期随时可能变
- 无人值守的长任务:第三方的 1,670 次调用就是例子
- 想本地部署的个人:321B,16GB/24GB 显卡不用考虑
- 需要明确评测再选型的人:目前只有厂商自测和零散第三方,没有 AA 这类统一榜单
最后
Nex-N2.6 不是“免费的前沿模型”,它是一个被免费开放出来的 321B 智能体实验品。
它有能力:OSWorld 83 分,工具调用、图片理解、262K 上下文都在线。它也有明显的短板:遇到需要“发现隐藏模式”的题,它会用同一种动作反复试,直到上下文爆掉。
免费 API 最值钱的地方,不是让你省下 10 美元,是让你用真实任务测出它的停止条件。
321B 的模型不缺能力,缺的是一条止损线。
这条线,得你来画。
参考来源:
暂无评论。