Google 把写论文拆成了五个 Agent,然后自己出题
先说结果。
Google Cloud AI Research 放出了 PaperOrchestra,一个把整篇论文写出来给你截图:输入是想法摘要和实验日志,输出是排好版、能直接投的 LaTeX 手稿。
论文 2026 年 4 月 6 日上 arXiv,5 月 1 日建库,到 11 月 18 日 3008 星。
五个角色:大纲、文献、配图、写作、精修。
但真正值得看的不是分工,是它怎么证明自己比别的 Agent 强,以及跟人类写的比差多远。
五个 Agent 各干什么
论文里把调用次数写得清清楚楚:
| Agent | 调用次数 | 干什么 |
|---|---|---|
| Outline | 1 | 出大纲、配图计划、引用图谱 |
| 文献 | 20–30 | 10 路并发搜候选,再逐条查 Semantic Scholar |
| 配图 | 20–30 | 找少样本、规划、生成、VLM 批判、重画 |
| 写作 | 1 | 一次多模态调用写完整篇 LaTeX |
| 精修 | 5–7 | 拿模拟评审意见改,分数不涨就回滚 |
合计 60–70 次调用,平均 39.6 分钟。
对比对象是 AI Scientist-v2:40–45 次调用,35.1 分钟。也就是说,多花的力气主要在文献和配图上。
文献那一环有个细节值得抄。它把"找"和"验"拆成两步:先 10 路并发做搜索,把候选池攒起来;再逐条过 Semantic Scholar API,且限速在每秒 1 次。
为什么要拆?因为 Semantic Scholar 的接口速率是硬约束,串行搜索等于自废武功,并发验证又会被限流打回。拆开之后,搜索可以并行,验证排成队,总时间由慢的那一段决定。
这不是什么高深设计,是把"哪个环节有硬限制"想清楚了。
它自己出了张考卷
要证明自己写得好,得有个基准。于是它做了 PaperWritingBench。
做法是反推:从 CVPR 2025 和 ICLR 2025 各取 100 篇论文,把原文拆回"想法摘要 + 实验日志"。
拆的过程注意两件事。第一,去掉作者名和标题,防止模型认得这篇论文。第二,删掉所有引用、URL、图表编号——因为这些信息会暴露论文的"知识谱系",模型一看就知道该引谁。
最后交到模型手上的,是一份"我知道我做了什么实验、数据是什么,但我不知道该引谁"的原料。
这正是真实研究里最尴尬的阶段:实验做完了,稿子一个字没写。
两个会议也不是随便挑的。CVPR 是双栏,ICLR 是单栏,版面规则完全不同——考的是模型能不能适应模板,而不只是能不能写字。
赢了基线,但没赢人
结果分两组看。
先看跟 AI 基线比(Single Agent 和 AI Scientist-v2):文献综述质量,PaperOrchestra 胜率比对手高 50 到 68 个百分点;整体手稿质量,高 14 到 38 个百分点。
这个数字很漂亮。论文摘要也就写到这里。
但同一张柱状图里还有第三组:人类原文。
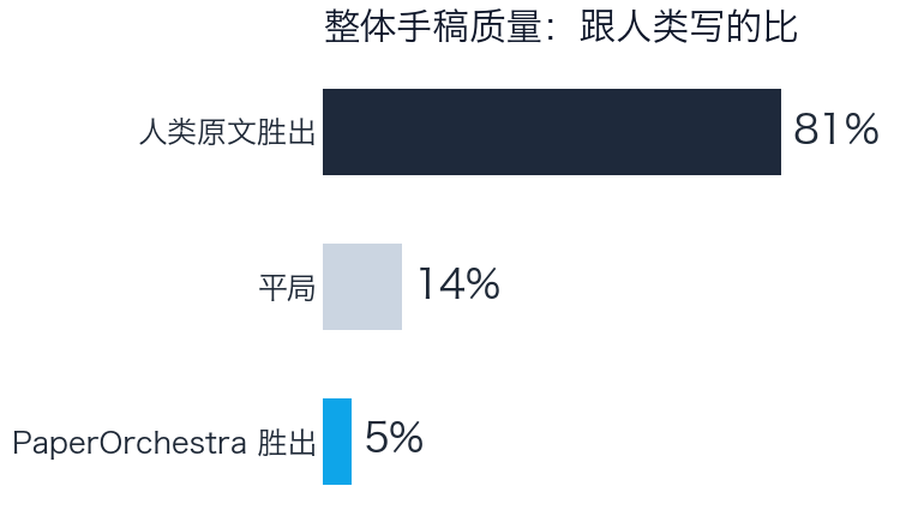
整体质量这一项,人类原文 81% 胜出,平局 14%,PaperOrchestra 只赢 5%。
文献综述那一项稍好——PaperOrchestra 对人类的胜率是 19%,人类胜 57%,平局 24%。
换句话说,把文献梳理得比别的 Agent 清楚,是真的;把论文写到人类水平,还没有。
那一小部分赢的 5% 值得一提:它赢的地方集中在文献覆盖广度和格式合规。这两件事恰好是程序能做到的——API 查得到、模板卡得住。
输的地方是判断。哪篇相关工作该引、哪个实验该重点讲、这个结论能推多远——这些没有 API 可以查。
精修那一环,79% 的改动是对的
论文里有个消融实验,我觉得比主结果更值得看。
它把"精修前"和"精修后"的稿子做盲测对比:79% 到 81% 的情况下,精修后的版本更好,0% 更差。
模拟评审系统的接受率也跟着涨:CVPR +19%,ICLR +22%。
精修的逻辑很朴素:改一版,让模拟评审打分,涨了就留,不涨就回滚,最多改 3 轮。论文里写,只有"总分上升"或"打平但各分项净增益非负"才保留改动。
这套机制之所以有效,是因为它把"改得好不好"从一个主观判断变成了一个可比较的分数。
但这里有个必须说清的边界:那个打分的是 AI 评审,不是真人审稿人。它能抓住表达不清、结构混乱、术语不一致,抓不住"这个实验设计有问题"。
一个刻意的限制
论文附录里有一句很关键的话:他们明确要求精修 Agent 忽略评审提出的补实验要求。
理由写得很直白:Agent 只会写稿,不会做实验。如果让它"补一个实验",它只能在论文里编造结果,或者写一句"我们将在未来工作中完成"。
这条限制看似小事,实际是整个系统诚信的底线。多 Agent 系统最常见的失败不是写不出来,是写得太顺——被评审指出缺实验,就顺手编一组数字,读起来天衣无缝。
同样的谨慎也出现在数据集上:仓库里没有 PaperWritingBench 的数据集,README 只写"将在之后单独发布"。也就是说,外面的人现在无法复现它的评测,只能看论文里的数字。
项目页给了几张生成的论文截图(CVPR 和 ICLR 各两版,一版用真图、一版用生成图),但没有给完整数据集。
这不是造假,是学术项目常见的发布节奏。不过它意味着:现阶段所有"比基线高 50 个百分点"的说法,都建立在作者提供的数据上。
这四十秒里发生了什么
39.6 分钟,60 到 70 次调用,产出一篇带文献综述、带图、排版合规的论文初稿。
这个速度意味着什么?
一篇 CVPR 论文,一个博士生从实验做完到投出去,通常要两到四周。改语言、补文献、调图表、对齐格式,全是耗时间但不产生新知识的部分。
PaperOrchestra 干的就是这一段。
它不会替你想 idea,不会替你设计实验,不会替你判断这个结果值不值得发。它把"实验做完了但稿子还没写"这个状态,压缩到四十分钟。
所以真正的用法不是"让 AI 写论文",是把初稿的成本降到接近零,然后你花时间在它写不了的地方:这篇该不该投、这个 baseline 选得对不对、结论是不是过度声称。
arXiv 上每天有大量论文因为写作质量被拒。这一层如果能被工具解决,评审就能把注意力放回方法本身。
反过来说,如果这一层被工具解决,投稿量会涨得更快,评审的负担会更重。
谁该试
适合:
- 实验做完了、数据齐了、缺一份能投的初稿
- 需要按目标会议模板排版,不想手工调 LaTeX
- 想先看看自己的实验在"标准叙事"里长什么样
不适合:
- 实验还没做,指望它替你想 idea
- 希望它一次生成就能投——它自己承认跟人类差 25 倍胜率
- 需要复现它的评测——数据集还没放出来
跑起来要 Python 3.11、Conda 环境、Semantic Scholar API key,Gemini 或 OpenAI 的 key 二选一。仓库 5 月建,11 月 15 日还在修 bug(invalid escape sequences、缺依赖、可选依赖处理),不算成熟,但活着。
作者在论文里写了句免责声明,值得抄下来:这是辅助工具,不是能主张作者身份的主体;事实准确性、原创性、结论有效性的责任,仍然在人。
这句话在一个能 40 分钟写完论文的系统里,比在任何别的地方都重要。
参考来源:
暂无评论。